{
"cells": [
{
"cell_type": "markdown",
"id": "ef54b620-4aa5-4797-bdf4-75dc815d4295",
"metadata": {},
"source": [
"# a. 使用大模型 API 对视频进行快速摘要(音频处理)- 完整版\n",
"> [HW9: Quick Summary of Lecture Video (演講影片快速摘要)](https://colab.research.google.com/drive/1Ysr25kz6lP7gR8DNTkJMAqOuMp2bhXes?usp=sharing#scrollTo=UULEr1GpDAl6)中文镜像版 | [PDF](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/GenAI_PDF/HW9.pdf)\n",
"> \n",
"> 这里的变量名与 HW9 基本保持一致。\n",
">\n",
"> 指导文章:[15. 用 API 实现 AI 视频摘要:动手制作属于你的 AI 视频助手](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/Guide/15.%20用%20API%20实现%20AI%20视频摘要:动手制作属于你的%20AI%20视频助手.md)\n",
"> \n",
"\n",
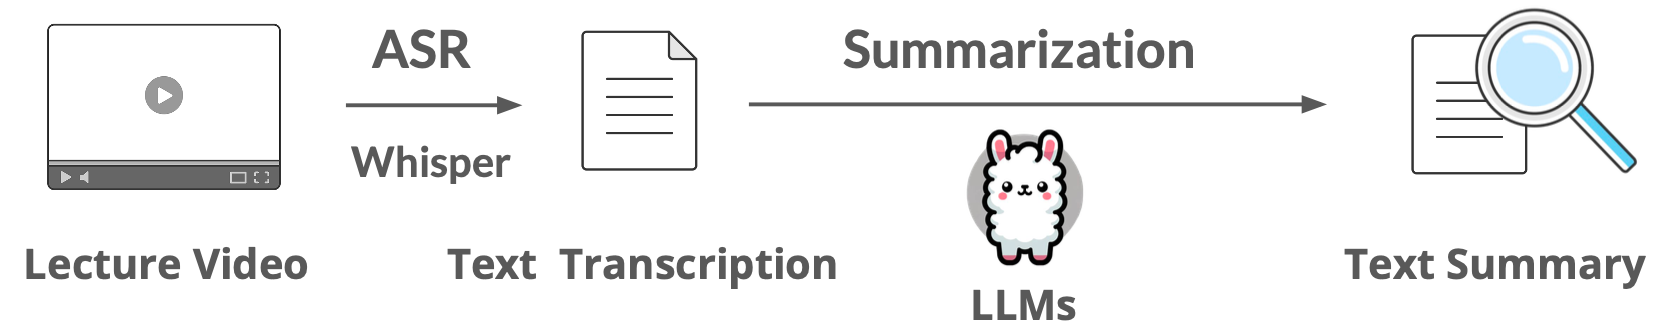
"**目标:** 学习如何使用现成的 API 快速构建语音识别相关的应用。\n",
"\n",
"\n",
"\n",
"注意,这里没有视觉上的识别。\n",
"\n",
"如果你遇到了 443 或者代理端口错误,请查看[《a. 使用 HFD 加快 Hugging Face 模型和数据集的下载》](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/Guide/a.%20使用%20HFD%20加快%20Hugging%20Face%20模型和数据集的下载.md#可能存在的问题443-和-git-clone-failed)。\n",
"\n",
"你也可以尝试运行 [b. 精简版](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/Demos/13b.%20轻松开始你的第一次%20AI%20视频总结(API%20版)-%20精简版.ipynb),适合一键执行查看效果,其中只保留了核心代码。\n",
"\n",
"在线链接:[Colab](https://colab.research.google.com/drive/1lljAy2lHUoqdQOI7xxCEkP6Ao8IRiNe0?usp=sharing) | [Kaggle - 精简版](https://www.kaggle.com/code/aidemos/13b-ai-api) | [Colab - 精简版](https://colab.research.google.com/drive/1uMMSKCoht1p3niW5NqUfi62hYCbe2yr-?usp=sharing)\n",
"\n",
"这里还有一个简单的 [🎡 AI Summarizer 脚本](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/CodePlayground/summarizer.py)供你尝试,命令行执行:\n",
"```bash\n",
"python summarizer.py ./example_video.mp4\n",
"```"
]
},
{
"cell_type": "markdown",
"id": "a20d3388-3394-4988-b8f2-279221ffec2d",
"metadata": {},
"source": [
"## 第1部分 - 准备\n",
"\n",
"### 提供的作业演讲视频\n",
"\n",
"(1) 为了方便处理,已将其转换为 MP3 文件。\n",
"\n",
"(2) 如果你想查看原始视频,请点击以下链接:\n",
"\n",
"- 李琳山教授 信号与人生 (2023)\n",
"\n",
" - 视频:[YouTube](https://www.youtube.com/watch?v=MxoQV4M0jY8) | [Bilibili](https://www.bilibili.com/video/BV14P411B7Le)\n",
"\n",
"\n",
"(3) 由于原始演讲视频较长,选取了从 1:43:24 到 2:00:49 的片段用于此次演示。"
]
},
{
"cell_type": "markdown",
"id": "5ba593bc-4200-4d9e-82b2-4fc74afae106",
"metadata": {},
"source": [
"### 安装必要的库\n",
"\n",
"这里需要一点时间。\n",
"\n",
"注意,过去的 Colab 的版本在本地运行可能存在一些问题,你可以参考下方指示进行修改:\n",
"1. 下载的OpenCC==1.1.7可能会遇到报错:\n",
">ImportError: /lib/x86_64-linux-gnu/libc.so.6: version `GLIBC_2.32' not found\n",
"\n",
"可以选择将版本降到 1.1.6 避免这个问题,解决方法来源: [OpenCC Issues#832](https://github.com/BYVoid/OpenCC/issues/832)\n",
"\n",
"2. 本地运行还可能遇到:\n",
"> ImportError: To support decoding audio files, please install 'librosa' and 'soundfile'.\n",
"\n",
"对应增加安装指令即可。\n"
]
},
{
"cell_type": "code",
"execution_count": 1,
"id": "56807783-8e56-4ff1-9d8f-b38295b4434b",
"metadata": {
"scrolled": true
},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"Looking in indexes: http://mirrors.aliyun.com/pypi/simple\n",
"Requirement already satisfied: srt==3.5.3 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (3.5.3)\n",
"Requirement already satisfied: datasets==4.0.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets[audio]==4.0.0) (4.0.0)\n",
"Requirement already satisfied: openai==2.32.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (2.32.0)\n",
"Requirement already satisfied: openai-whisper==20250625 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (20250625)\n",
"Requirement already satisfied: soundfile==0.13.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (0.13.1)\n",
"Requirement already satisfied: ipywidgets==8.1.8 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (8.1.8)\n",
"Requirement already satisfied: librosa==0.11.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (0.11.0)\n",
"Requirement already satisfied: torchcodec==0.5 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (0.5)\n",
"Requirement already satisfied: filelock in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (3.29.0)\n",
"Requirement already satisfied: numpy>=1.17 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (2.2.6)\n",
"Requirement already satisfied: pyarrow>=15.0.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (23.0.1)\n",
"Requirement already satisfied: dill<0.3.9,>=0.3.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (0.3.8)\n",
"Requirement already satisfied: pandas in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (2.3.3)\n",
"Requirement already satisfied: requests>=2.32.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (2.33.1)\n",
"Requirement already satisfied: tqdm>=4.66.3 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (4.67.3)\n",
"Requirement already satisfied: xxhash in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (3.6.0)\n",
"Requirement already satisfied: multiprocess<0.70.17 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (0.70.16)\n",
"Requirement already satisfied: fsspec<=2025.3.0,>=2023.1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (2025.3.0)\n",
"Requirement already satisfied: huggingface-hub>=0.24.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (0.36.2)\n",
"Requirement already satisfied: packaging in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (26.1)\n",
"Requirement already satisfied: pyyaml>=5.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from datasets==4.0.0->datasets[audio]==4.0.0) (6.0.3)\n",
"Requirement already satisfied: anyio<5,>=3.5.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (4.13.0)\n",
"Requirement already satisfied: distro<2,>=1.7.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (1.9.0)\n",
"Requirement already satisfied: httpx<1,>=0.23.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (0.28.1)\n",
"Requirement already satisfied: jiter<1,>=0.10.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (0.14.0)\n",
"Requirement already satisfied: pydantic<3,>=1.9.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (2.12.3)\n",
"Requirement already satisfied: sniffio in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (1.3.1)\n",
"Requirement already satisfied: typing-extensions<5,>=4.11 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai==2.32.0) (4.15.0)\n",
"Requirement already satisfied: more-itertools in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai-whisper==20250625) (11.0.2)\n",
"Requirement already satisfied: numba in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai-whisper==20250625) (0.61.2)\n",
"Requirement already satisfied: tiktoken in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai-whisper==20250625) (0.12.0)\n",
"Requirement already satisfied: torch in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai-whisper==20250625) (2.7.1)\n",
"Requirement already satisfied: triton>=2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openai-whisper==20250625) (3.3.1)\n",
"Requirement already satisfied: cffi>=1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from soundfile==0.13.1) (2.0.0)\n",
"Requirement already satisfied: comm>=0.1.3 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipywidgets==8.1.8) (0.2.3)\n",
"Requirement already satisfied: ipython>=6.1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipywidgets==8.1.8) (9.12.0)\n",
"Requirement already satisfied: traitlets>=4.3.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipywidgets==8.1.8) (5.14.3)\n",
"Requirement already satisfied: widgetsnbextension~=4.0.14 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipywidgets==8.1.8) (4.0.15)\n",
"Requirement already satisfied: jupyterlab_widgets~=3.0.15 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipywidgets==8.1.8) (3.0.16)\n",
"Requirement already satisfied: audioread>=2.1.9 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (3.1.0)\n",
"Requirement already satisfied: scipy>=1.6.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (1.17.1)\n",
"Requirement already satisfied: scikit-learn>=1.1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (1.8.0)\n",
"Requirement already satisfied: joblib>=1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (1.5.3)\n",
"Requirement already satisfied: decorator>=4.3.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (5.2.1)\n",
"Requirement already satisfied: pooch>=1.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (1.9.0)\n",
"Requirement already satisfied: soxr>=0.3.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (1.0.0)\n",
"Requirement already satisfied: lazy_loader>=0.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (0.5)\n",
"Requirement already satisfied: msgpack>=1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from librosa==0.11.0) (1.1.2)\n",
"Requirement already satisfied: idna>=2.8 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from anyio<5,>=3.5.0->openai==2.32.0) (3.11)\n",
"Requirement already satisfied: aiohttp!=4.0.0a0,!=4.0.0a1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (3.13.5)\n",
"Requirement already satisfied: certifi in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from httpx<1,>=0.23.0->openai==2.32.0) (2026.2.25)\n",
"Requirement already satisfied: httpcore==1.* in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from httpx<1,>=0.23.0->openai==2.32.0) (1.0.9)\n",
"Requirement already satisfied: h11>=0.16 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from httpcore==1.*->httpx<1,>=0.23.0->openai==2.32.0) (0.16.0)\n",
"Requirement already satisfied: annotated-types>=0.6.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pydantic<3,>=1.9.0->openai==2.32.0) (0.7.0)\n",
"Requirement already satisfied: pydantic-core==2.41.4 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pydantic<3,>=1.9.0->openai==2.32.0) (2.41.4)\n",
"Requirement already satisfied: typing-inspection>=0.4.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pydantic<3,>=1.9.0->openai==2.32.0) (0.4.2)\n",
"Requirement already satisfied: aiohappyeyeballs>=2.5.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (2.6.1)\n",
"Requirement already satisfied: aiosignal>=1.4.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (1.4.0)\n",
"Requirement already satisfied: attrs>=17.3.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (26.1.0)\n",
"Requirement already satisfied: frozenlist>=1.1.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (1.8.0)\n",
"Requirement already satisfied: multidict<7.0,>=4.5 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (6.7.1)\n",
"Requirement already satisfied: propcache>=0.2.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (0.4.1)\n",
"Requirement already satisfied: yarl<2.0,>=1.17.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from aiohttp!=4.0.0a0,!=4.0.0a1->fsspec[http]<=2025.3.0,>=2023.1.0->datasets==4.0.0->datasets[audio]==4.0.0) (1.23.0)\n",
"Requirement already satisfied: pycparser in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from cffi>=1.0->soundfile==0.13.1) (3.0)\n",
"Requirement already satisfied: hf-xet<2.0.0,>=1.1.3 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from huggingface-hub>=0.24.0->datasets==4.0.0->datasets[audio]==4.0.0) (1.4.3)\n",
"Requirement already satisfied: ipython-pygments-lexers>=1.0.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (1.1.1)\n",
"Requirement already satisfied: jedi>=0.18.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (0.19.2)\n",
"Requirement already satisfied: matplotlib-inline>=0.1.6 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (0.2.1)\n",
"Requirement already satisfied: pexpect>4.6 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (4.9.0)\n",
"Requirement already satisfied: prompt_toolkit<3.1.0,>=3.0.41 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (3.0.52)\n",
"Requirement already satisfied: pygments>=2.14.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (2.20.0)\n",
"Requirement already satisfied: stack_data>=0.6.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from ipython>=6.1.0->ipywidgets==8.1.8) (0.6.3)\n",
"Requirement already satisfied: wcwidth in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from prompt_toolkit<3.1.0,>=3.0.41->ipython>=6.1.0->ipywidgets==8.1.8) (0.6.0)\n",
"Requirement already satisfied: parso<0.9.0,>=0.8.4 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from jedi>=0.18.2->ipython>=6.1.0->ipywidgets==8.1.8) (0.8.6)\n",
"Requirement already satisfied: llvmlite<0.45,>=0.44.0dev0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from numba->openai-whisper==20250625) (0.44.0)\n",
"Requirement already satisfied: ptyprocess>=0.5 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pexpect>4.6->ipython>=6.1.0->ipywidgets==8.1.8) (0.7.0)\n",
"Requirement already satisfied: platformdirs>=2.5.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pooch>=1.1->librosa==0.11.0) (4.9.6)\n",
"Requirement already satisfied: charset_normalizer<4,>=2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from requests>=2.32.2->datasets==4.0.0->datasets[audio]==4.0.0) (3.4.7)\n",
"Requirement already satisfied: urllib3<3,>=1.26 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from requests>=2.32.2->datasets==4.0.0->datasets[audio]==4.0.0) (2.6.3)\n",
"Requirement already satisfied: threadpoolctl>=3.2.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from scikit-learn>=1.1.0->librosa==0.11.0) (3.6.0)\n",
"Requirement already satisfied: executing>=1.2.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from stack_data>=0.6.0->ipython>=6.1.0->ipywidgets==8.1.8) (2.2.1)\n",
"Requirement already satisfied: asttokens>=2.1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from stack_data>=0.6.0->ipython>=6.1.0->ipywidgets==8.1.8) (3.0.1)\n",
"Requirement already satisfied: pure-eval in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from stack_data>=0.6.0->ipython>=6.1.0->ipywidgets==8.1.8) (0.2.3)\n",
"Requirement already satisfied: setuptools in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (79.0.1)\n",
"Requirement already satisfied: sympy>=1.13.3 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (1.14.0)\n",
"Requirement already satisfied: networkx in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (3.6.1)\n",
"Requirement already satisfied: jinja2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (3.1.6)\n",
"Requirement already satisfied: nvidia-cuda-nvrtc-cu12==12.6.77 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.6.77)\n",
"Requirement already satisfied: nvidia-cuda-runtime-cu12==12.6.77 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.6.77)\n",
"Requirement already satisfied: nvidia-cuda-cupti-cu12==12.6.80 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.6.80)\n",
"Requirement already satisfied: nvidia-cudnn-cu12==9.5.1.17 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (9.5.1.17)\n",
"Requirement already satisfied: nvidia-cublas-cu12==12.6.4.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.6.4.1)\n",
"Requirement already satisfied: nvidia-cufft-cu12==11.3.0.4 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (11.3.0.4)\n",
"Requirement already satisfied: nvidia-curand-cu12==10.3.7.77 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (10.3.7.77)\n",
"Requirement already satisfied: nvidia-cusolver-cu12==11.7.1.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (11.7.1.2)\n",
"Requirement already satisfied: nvidia-cusparse-cu12==12.5.4.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.5.4.2)\n",
"Requirement already satisfied: nvidia-cusparselt-cu12==0.6.3 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (0.6.3)\n",
"Requirement already satisfied: nvidia-nccl-cu12==2.26.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (2.26.2)\n",
"Requirement already satisfied: nvidia-nvtx-cu12==12.6.77 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.6.77)\n",
"Requirement already satisfied: nvidia-nvjitlink-cu12==12.6.85 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (12.6.85)\n",
"Requirement already satisfied: nvidia-cufile-cu12==1.11.1.6 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from torch->openai-whisper==20250625) (1.11.1.6)\n",
"Requirement already satisfied: mpmath<1.4,>=1.1.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from sympy>=1.13.3->torch->openai-whisper==20250625) (1.3.0)\n",
"Requirement already satisfied: MarkupSafe>=2.0 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from jinja2->torch->openai-whisper==20250625) (3.0.3)\n",
"Requirement already satisfied: python-dateutil>=2.8.2 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pandas->datasets==4.0.0->datasets[audio]==4.0.0) (2.9.0.post0)\n",
"Requirement already satisfied: pytz>=2020.1 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pandas->datasets==4.0.0->datasets[audio]==4.0.0) (2026.1.post1)\n",
"Requirement already satisfied: tzdata>=2022.7 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from pandas->datasets==4.0.0->datasets[audio]==4.0.0) (2026.1)\n",
"Requirement already satisfied: six>=1.5 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from python-dateutil>=2.8.2->pandas->datasets==4.0.0->datasets[audio]==4.0.0) (1.17.0)\n",
"Requirement already satisfied: regex>=2022.1.18 in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from tiktoken->openai-whisper==20250625) (2026.4.4)\n",
"Note: you may need to restart the kernel to use updated packages.\n",
"Looking in indexes: http://mirrors.aliyun.com/pypi/simple\n",
"Requirement already satisfied: OpenCC in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (1.3.1)\n",
"Requirement already satisfied: openpyxl in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (3.1.5)\n",
"Requirement already satisfied: et-xmlfile in /root/autodl-tmp/AI-Guide-and-Demos-zh_CN/.venv/lib/python3.12/site-packages (from openpyxl) (2.0.0)\n",
"Note: you may need to restart the kernel to use updated packages.\n"
]
}
],
"source": [
"%pip install \\\n",
" \"srt==3.5.3\" \\\n",
" \"datasets[audio]==4.0.0\" \\\n",
" \"openai==2.32.0\" \\\n",
" \"openai-whisper==20250625\" \\\n",
" \"soundfile==0.13.1\" \\\n",
" \"ipywidgets==8.1.8\" \\\n",
" \"librosa==0.11.0\" \\\n",
" \"torchcodec==0.5\" # 注意,该库需要匹配torch版本进行安装:https://github.com/meta-pytorch/torchcodec#installing-torchcodec\n",
"%pip install OpenCC openpyxl\n",
"#%pip install 'httpx<0.28.0' # 降级 httpx 以解决关键字 'proxies' 被移除的问题,最新的 openai 库不会引发该问题,故默认注释"
]
},
{
"cell_type": "markdown",
"id": "9299e157-4bb0-4972-a8a7-a1e2488a1b49",
"metadata": {},
"source": [
"### 导入"
]
},
{
"cell_type": "code",
"execution_count": 2,
"id": "32ec887d-3ae6-4878-9905-b7ba75ea7753",
"metadata": {},
"outputs": [],
"source": [
"# 标准库\n",
"import os\n",
"# 设置模型下载镜像,用于非本地数据集\n",
"os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'\n",
"\n",
"import time\n",
"import re\n",
"import pathlib\n",
"import textwrap\n",
"import datetime\n",
"\n",
"# 第三方库\n",
"import numpy as np\n",
"import srt\n",
"import soundfile as sf\n",
"from opencc import OpenCC\n",
"from tqdm import tqdm\n",
"import ipywidgets as widgets\n",
"from IPython.display import display, Markdown\n",
"\n",
"# 项目相关库(如语音识别和API调用等)\n",
"import whisper\n",
"from datasets import load_dataset\n",
"from openai import OpenAI"
]
},
{
"cell_type": "markdown",
"id": "b317e682-dd8b-47bc-9b5c-7ad18ba740b9",
"metadata": {},
"source": [
"### 下载数据\n",
"\n",
"已经上传至 data 文件夹中,不需要再下载。"
]
},
{
"cell_type": "code",
"execution_count": 3,
"id": "a2f6481d-a710-4bc0-9abe-f614a8178d95",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"现在我们将转录音频: 李琳山教授 信号与人生 (2023) (NTU-GenAI-2024-HW9.mp3)。\n"
]
}
],
"source": [
"# 加载数据集\n",
"dataset_name = \"kuanhuggingface/NTU-GenAI-2024-HW9\"\n",
"dataset = load_dataset(dataset_name)\n",
"\n",
"\n",
"# 加载本地 Parquet 格式的数据集\n",
"# dataset = load_dataset('parquet', data_files={'test': './data/13/test-00000-of-00001.parquet'})\n",
"\n",
"# 准备音频\n",
"input_audio = dataset[\"test\"][0][\"audio\"]\n",
"input_audio_name = dataset[\"test\"][0][\"file\"]\n",
"samples = input_audio.get_all_samples()\n",
"input_audio_array = samples.data.numpy().mean(axis=0).astype(np.float32)\n",
"sampling_rate = samples.sample_rate\n",
"\n",
"print(f\"现在我们将转录音频: 李琳山教授 信号与人生 (2023) ({input_audio_name})。\")"
]
},
{
"cell_type": "markdown",
"id": "81fd3ada-646a-4a85-a7fe-3d498bb03560",
"metadata": {},
"source": [
"#### 直接加载 .mp3 文件(和上面二选一)\n"
]
},
{
"cell_type": "code",
"execution_count": 4,
"id": "d71e9869-e2a9-4ebe-96c6-c96364afdcfc",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"采样率: 16000\n",
"音频数据形状: (16720000,)\n",
"现在我们将转录音频: 李琳山教授 信号与人生 (2023) (audio.mp3)。\n"
]
}
],
"source": [
"import librosa\n",
"\n",
"# 指定音频文件路径\n",
"mp3_file_path = './data/13/audio.mp3'\n",
"\n",
"input_audio_name = os.path.basename(mp3_file_path)\n",
"\n",
"# 加载音频文件,指定采样率为 16000\n",
"input_audio_array, sampling_rate = librosa.load(mp3_file_path, sr=16000)\n",
"\n",
"# 打印音频数据的采样率和形状,确保加载成功\n",
"print(f\"采样率: {sampling_rate}\")\n",
"print(f\"音频数据形状: {input_audio_array.shape}\")\n",
"\n",
"print(f\"现在我们将转录音频: 李琳山教授 信号与人生 (2023) ({input_audio_name})。\")"
]
},
{
"cell_type": "markdown",
"id": "4b7bb38b-bd7a-4ddf-9210-3b55b1b9525e",
"metadata": {},
"source": [
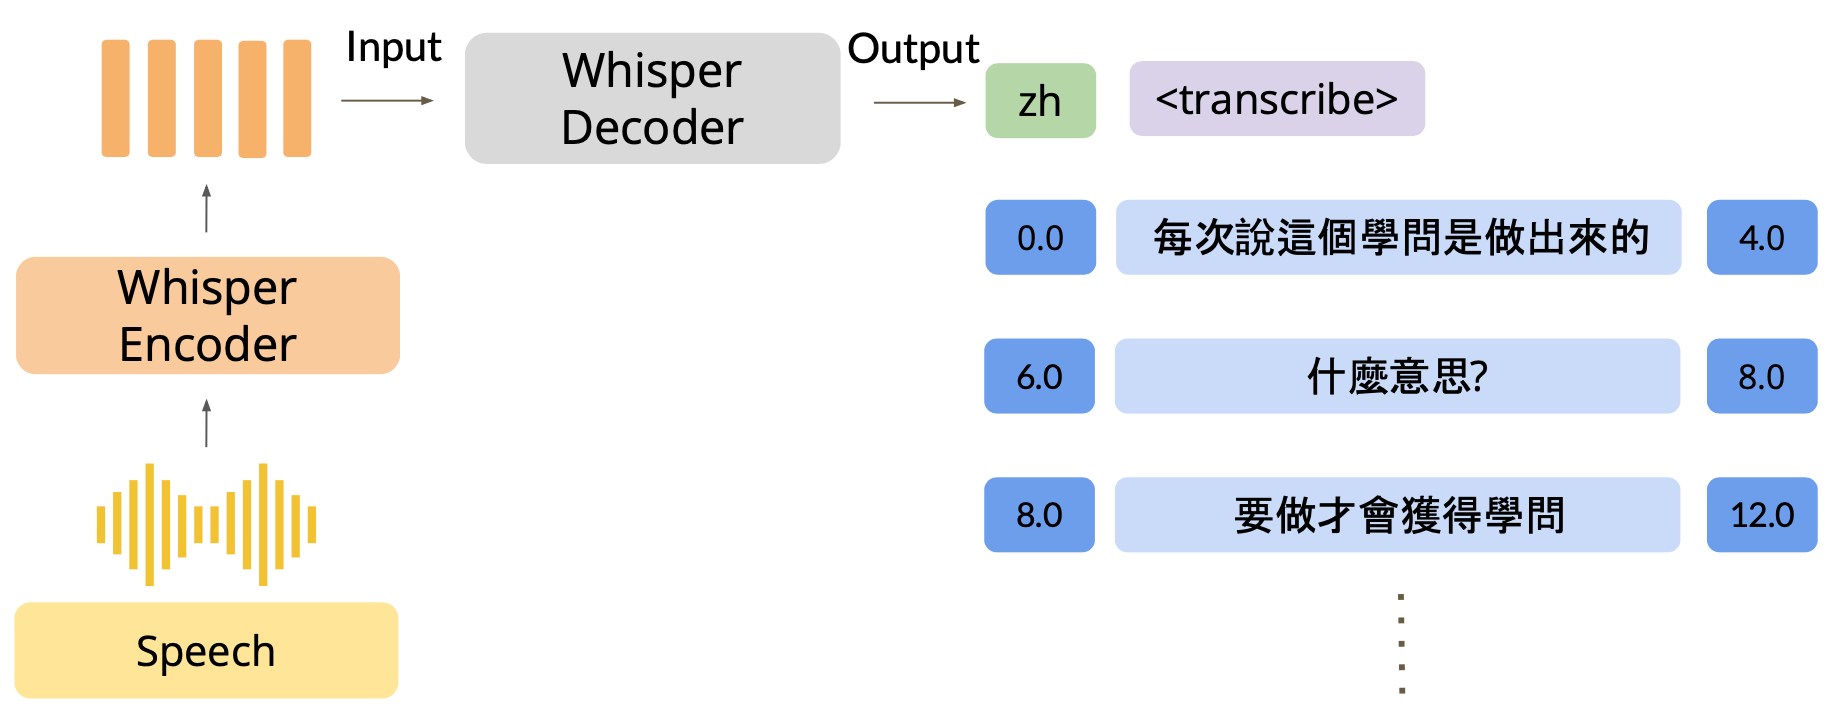
"## 第2部分 - 自动语音识别 (ASR)\n",
"\n",
"下图是处理的样例过程,对应于之后所使用的音频:\n",
"\n",
"\n"
]
},
{
"cell_type": "markdown",
"id": "e78c53a6-4df7-4d41-b913-f382ec2d751d",
"metadata": {},
"source": [
"### 定义语音识别函数\n",
"\n",
"函数 `speech_recognition()` 旨在将音频转换为字幕。"
]
},
{
"cell_type": "code",
"execution_count": 5,
"id": "8b9bd0bc-efe9-4bf3-8c53-6de03f3cafdb",
"metadata": {},
"outputs": [],
"source": [
"def speech_recognition(model_name, input_audio, output_subtitle_path, decode_options, cache_dir=\"./\"):\n",
" \"\"\"\n",
" 将音频转换为字幕(使用 OpenAI Whisper 模型)。\n",
"\n",
" 参数:\n",
" model_name (str): 模型名称。Whisper 提供五种模型尺寸,包括 tiny, base, small, medium, large-v3\n",
" 例如,你可以使用 'tiny'、'base'、'small'、'medium'、'large-v3' 来指定模型名称\n",
" 详细信息请见:https://github.com/openai/whisper\n",
"\n",
" input_audio (Union[str, np.ndarray, torch.Tensor]): 输入音频,可以是音频文件路径,也可以是音频波形\n",
" - 如果输入是音频路径,例如 'input.wav',可以直接传入 'input.wav';\n",
" - 如果输入是音频数组,例如变量名为 'audio_array',则可以直接传入 'audio_array'\n",
"\n",
" output_subtitle_path (str): 输出字幕文件路径\n",
" 例如,如果你想将字幕文件保存为 'output.srt',可以使用 'output.srt' 作为输出路径\n",
"\n",
" decode_options (dict): 转录/解码选项。当前函数中会使用到以下键:\n",
" - language (str): 指定音频的语言,例如 'zh'、'en' 等\n",
" - initial_prompt (str 或 None): 提供给模型的初始文本 prompt\n",
" 这可以用于提供上下文(例如专有名词、术语等),以提高识别准确性\n",
" 默认值通常为 None\n",
" - temperature (float): 采样温度。值越高,随机性越强;值越低,输出越稳定\n",
" 默认值通常为 0.0\n",
"\n",
" 更多可用选项及其含义,可以参考:\n",
" https://github.com/openai/whisper/blob/main/whisper/decoding.py\n",
" https://github.com/openai/whisper/blob/main/whisper/transcribe.py\n",
"\n",
" cache_dir (str): 用于缓存/保存模型权重的目录路径\n",
" 例如,你可以使用 'cache' 来指定缓存目录\n",
" 默认值: \"./\"\n",
"\n",
" 示例:\n",
" 如果你想使用 'base' 模型将 'input.wav' 转换为 'output.srt',并将缓存文件保存在\n",
" 'cache' 目录中,可以按如下方式调用此函数:\n",
"\n",
" decode_options = {\n",
" \"language\": \"zh\",\n",
" \"initial_prompt\": None,\n",
" \"temperature\": 0.0,\n",
" }\n",
"\n",
" speech_recognition(\n",
" model_name=\"base\",\n",
" input_audio=\"input.wav\",\n",
" output_subtitle_path=\"output.srt\",\n",
" decode_options=decode_options,\n",
" cache_dir=\"cache\",\n",
" )\n",
" \"\"\"\n",
"\n",
" # 记录开始时间\n",
" start_time = time.time()\n",
"\n",
" print(f\"=============== 正在加载 Whisper-{model_name} ===============\")\n",
"\n",
" # 加载模型\n",
" model = whisper.load_model(name=model_name, download_root=cache_dir)\n",
"\n",
" print(f\"=============== 正在转录音频 ===============\")\n",
"\n",
" # 转录音频\n",
" transcription = model.transcribe(audio=input_audio, language=decode_options[\"language\"], verbose=False,\n",
" initial_prompt=decode_options[\"initial_prompt\"], temperature=decode_options[\"temperature\"])\n",
"\n",
" # 记录结束时间\n",
" end_time = time.time()\n",
"\n",
" print(f\"语音识别过程耗时 {end_time - start_time} 秒。\")\n",
"\n",
" subtitles = []\n",
" # 将转录内容转换为字幕并遍历所有片段\n",
" for i, segment in tqdm(enumerate(transcription[\"segments\"])):\n",
"\n",
" # 将开始时间转换为字幕格式\n",
" start_time = datetime.timedelta(seconds=segment[\"start\"])\n",
"\n",
" # 将结束时间转换为字幕格式\n",
" end_time = datetime.timedelta(seconds=segment[\"end\"])\n",
"\n",
" # 获取字幕文本\n",
" text = segment[\"text\"]\n",
"\n",
" # 将字幕添加到字幕列表中\n",
" subtitles.append(srt.Subtitle(index=i, start=start_time, end=end_time, content=text))\n",
"\n",
" # 将字幕列表转换为字幕内容\n",
" srt_content = srt.compose(subtitles)\n",
"\n",
" print(f\"\\n=============== 正在将字幕保存到 {output_subtitle_path} ===============\")\n",
"\n",
" # 将字幕内容保存到文件中\n",
" with open(output_subtitle_path, \"w\", encoding=\"utf-8\") as file:\n",
" file.write(srt_content)\n",
"\n",
" print(f\"\\n=============== 字幕保存完成 ===============\")"
]
},
{
"cell_type": "markdown",
"id": "266026e8-8762-4282-8eb6-52ddb0eb630a",
"metadata": {},
"source": [
"### 设置参数\n",
"\n",
"注意,这里设置的参数都是 Whisper 相关的,与后续的 AI 摘要不同。\n",
"\n",
"你可以通过 model_name 设置不同的模型,使用**标识**指定。通过[官方仓库](https://github.com/openai/whisper)所提供的数据,我们可以看到不同模型需要的显存大小:\n",
"\n",
"| Size | Parameters | English-only model | Multilingual model | Required VRAM | Relative speed |\n",
"| ------ | ---------- | ------------------ | ------------------ | ------------- | -------------- |\n",
"| tiny | 39 M | `tiny.en` | `tiny` | ~1 GB | ~32x |\n",
"| base | 74 M | `base.en` | `base` | ~1 GB | ~16x |\n",
"| small | 244 M | `small.en` | `small` | ~2 GB | ~6x |\n",
"| medium | 769 M | `medium.en` | `medium` | ~5 GB | ~2x |\n",
"| large | 1550 M | N/A | `large` | ~10 GB | 1x |\n",
"\n",
"**解释:**\n",
"\n",
"- **Size (大小)**:表示模型的尺寸,不同大小的模型训练时使用的数据量不同,因此性能和精度也不同。较大的模型通常会有更高的精度。`Medium` 是个不错的选择,`tiny` 和 `base` 效果一般,用于学习的话也可以。\n",
"- **Parameters (参数量)**:模型的参数数量,表示模型的复杂度。参数越多,模型的性能通常越好,但也会占用更多的计算资源。\n",
"- **English-only model (仅限英文模型)**:模型的**标识**名称,只用于处理英文音频转录,适用于仅需要处理英文语音的场景。\n",
"- **Multilingual model (多语言模型)**:模型的**标识**名称,用于在代码中加载相应的模型,对应于接下来的 `model_name` 参数。\n",
"- **Required VRAM (所需显存)**:指运行该模型时所需的显存大小。如果你对参数和显存的对应关系感兴趣,可以阅读之前的文章:[《07. 探究模型参数与显存的关系以及不同精度造成的影响.md》](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/Guide/07.%20探究模型参数与显存的关系以及不同精度造成的影响.md)。\n",
"- **Relative speed (相对速度)**:相对速度表示模型处理语音转录任务的效率。数字越大,模型处理速度越快,与模型的参数量成反比。\n",
"\n",
"直接运行代码,交互式修改所需的参数及输入文件路径,不用关心这里的代码细节,除非你对交互感兴趣。\n",
"\n",
"注意:配置完记得点击**提交配置**"
]
},
{
"cell_type": "code",
"execution_count": 6,
"id": "aed82848-5a9a-423b-b3cd-435077522672",
"metadata": {},
"outputs": [
{
"data": {
"text/markdown": [
"**model_name**
请选择要使用的模型名称:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "f079b9737e074369a233b6fb3b6cdd2c",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Dropdown(description='model_name:', index=3, options=('tiny', 'base', 'small', 'medium', 'large-v3'), value='m…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**suffix**
设置输出文件名的后缀:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "746f7a7f93234205a1b78035e5b17b2a",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='信号与人生', description='suffix:')"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "548fef9b388146cb8a604619783fa101",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='./output-信号与人生.srt', description='字幕路径:', disabled=True)"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "5a3df8ba7ac74e83a1f7419eb6152034",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='./output-信号与人生.txt', description='原始文本路径:', disabled=True)"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**cache_dir**
设置模型和数据集缓存的目录路径:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "82084b638afa416aad17fdc68268898e",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='./', description='cache_dir:')"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**language**
设置演讲视频的语言:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "5914a144d87c46df81d43f322179501f",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='zh', description='language:')"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**initial_prompt**
用于提供初始文本prompt(可选):"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "920a3f3aba434ad6902ce4a760464ffb",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='请用中文', description='initial_prompt:')"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**temperature**
值越高,随机性越强:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "8e5bef3c29a54f7dad40694589e04f60",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"FloatSlider(value=0.0, continuous_update=False, description='temperature:', max=1.0)"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "baf90081c48345bbb2d1bc13293d2e7d",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Button(description='提交配置', style=ButtonStyle())"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "e63cc14cfb9547059ad561209cf28a68",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Output()"
]
},
"metadata": {},
"output_type": "display_data"
}
],
"source": [
"# ===== 在此代码块中,你可以修改所需的参数及输入文件路径 =====\n",
"# 模型名称部分\n",
"model_name_markdown = Markdown(\"**model_name**
请选择要使用的模型名称:\")\n",
"model_name_widget = widgets.Dropdown(\n",
" options=['tiny', 'base', 'small', 'medium', 'large-v3'],\n",
" value='medium',\n",
" description='model_name:',\n",
")\n",
"\n",
"# 输出文件的后缀部分\n",
"suffix_markdown = Markdown(\"**suffix**
设置输出文件名的后缀:\")\n",
"suffix_widget = widgets.Text(\n",
" value='信号与人生',\n",
" description='suffix:',\n",
")\n",
"\n",
"# 输出字幕文件和原始文本文件路径部分\n",
"output_subtitle_path_widget = widgets.Text(\n",
" value=f\"./output-信号与人生.srt\",\n",
" description='字幕路径:',\n",
" disabled=True # 禁用手动修改\n",
")\n",
"\n",
"output_raw_text_path_widget = widgets.Text(\n",
" value=f\"./output-信号与人生.txt\",\n",
" description='原始文本路径:',\n",
" disabled=True # 禁用手动修改\n",
")\n",
"\n",
"# 模型和数据集缓存目录部分\n",
"cache_dir_markdown = Markdown(\"**cache_dir**
设置模型和数据集缓存的目录路径:\")\n",
"cache_dir_widget = widgets.Text(\n",
" value='./',\n",
" description='cache_dir:',\n",
")\n",
"\n",
"# 演讲视频的语言部分\n",
"language_markdown = Markdown(\"**language**
设置演讲视频的语言:\")\n",
"language_widget = widgets.Text(\n",
" value='zh',\n",
" description='language:',\n",
")\n",
"\n",
"# 用于提供初始文本prompt(可选)\n",
"initial_prompt_markdown = Markdown(\"**initial_prompt**
用于提供初始文本prompt(可选):\")\n",
"initial_prompt_widget = widgets.Text(\n",
" value='请用中文',\n",
" description='initial_prompt:',\n",
")\n",
"\n",
"# 采样温度部分\n",
"temperature_markdown = Markdown(\"**temperature**
值越高,随机性越强:\")\n",
"temperature_widget = widgets.FloatSlider(\n",
" value=0,\n",
" min=0,\n",
" max=1,\n",
" step=0.1,\n",
" description='temperature:',\n",
" continuous_update=False\n",
")\n",
"\n",
"# 创建输出区域来显示打印内容\n",
"output_area = widgets.Output()\n",
"\n",
"# 获取用户输入值并更新路径\n",
"def on_button_click(b):\n",
" global model_name, suffix, output_subtitle_path, output_raw_text_path, cache_dir, language, initial_prompt, temperature\n",
" with output_area: # 使用 Output 小部件捕获输出\n",
" output_area.clear_output() # 清除之前的输出\n",
" model_name = model_name_widget.value\n",
" suffix = suffix_widget.value\n",
" output_subtitle_path = f\"./output-{suffix}.srt\" # 更新全局变量\n",
" output_raw_text_path = f\"./output-{suffix}.txt\" # 更新全局变量\n",
" cache_dir = cache_dir_widget.value\n",
" language = language_widget.value\n",
" initial_prompt = initial_prompt_widget.value\n",
" temperature = temperature_widget.value\n",
" \n",
" # 更新字幕文件路径和原始文本路径\n",
" output_subtitle_path_widget.value = output_subtitle_path\n",
" output_raw_text_path_widget.value = output_raw_text_path\n",
" \n",
" # 打印配置\n",
" print(f\"模型名称: {model_name}\")\n",
" print(f\"输出文件后缀: {suffix}\")\n",
" print(f\"字幕文件路径: {output_subtitle_path}\")\n",
" print(f\"原始文本路径: {output_raw_text_path}\")\n",
" print(f\"缓存目录: {cache_dir}\")\n",
" print(f\"语言: {language}\")\n",
" print(f\"初始prompt: {initial_prompt}\")\n",
" print(f\"采样温度: {temperature}\")\n",
"\n",
"# 创建提交按钮\n",
"submit_button = widgets.Button(description=\"提交配置\")\n",
"submit_button.on_click(on_button_click)\n",
"\n",
"# 显示带有说明的所有小部件\n",
"display(model_name_markdown, model_name_widget)\n",
"display(suffix_markdown, suffix_widget)\n",
"display(output_subtitle_path_widget, output_raw_text_path_widget)\n",
"display(cache_dir_markdown, cache_dir_widget)\n",
"display(language_markdown, language_widget)\n",
"display(initial_prompt_markdown, initial_prompt_widget)\n",
"display(temperature_markdown, temperature_widget)\n",
"\n",
"# 显示提交按钮\n",
"display(submit_button)\n",
"\n",
"# 显示输出区域\n",
"display(output_area)"
]
},
{
"cell_type": "markdown",
"id": "4fb1358e-49a7-4601-8c8f-32d1c6a67ec4",
"metadata": {},
"source": [
"**构建 DecodingOptions**"
]
},
{
"cell_type": "code",
"execution_count": 7,
"id": "c8058b4a-ea9c-4771-8361-c2bba6f1667f",
"metadata": {},
"outputs": [],
"source": [
"decode_options = {\n",
" \"language\": language,\n",
" \"initial_prompt\": initial_prompt,\n",
" \"temperature\": temperature\n",
"}"
]
},
{
"cell_type": "markdown",
"id": "dcda6b1e-e501-4844-998a-dea936322217",
"metadata": {},
"source": [
"**打印完整配置**"
]
},
{
"cell_type": "code",
"execution_count": 8,
"id": "0503049b-a8f4-4ddd-852c-014b065018d8",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"设置: (1) 模型: whisper-medium (2) 语言: zh (3) 初始prompt: 请用中文 (4) 温度: 0.0\n",
"转录 李琳山教授 信号与人生 (2023)\n"
]
}
],
"source": [
"message = \"转录 李琳山教授 信号与人生 (2023)\"\n",
"print(f\"设置: (1) 模型: whisper-{model_name} (2) 语言: {language} (3) 初始prompt: {initial_prompt} (4) 温度: {temperature}\")\n",
"print(message)"
]
},
{
"cell_type": "markdown",
"id": "b7cb886f-c86f-4145-bec2-b029b204ca8d",
"metadata": {},
"source": [
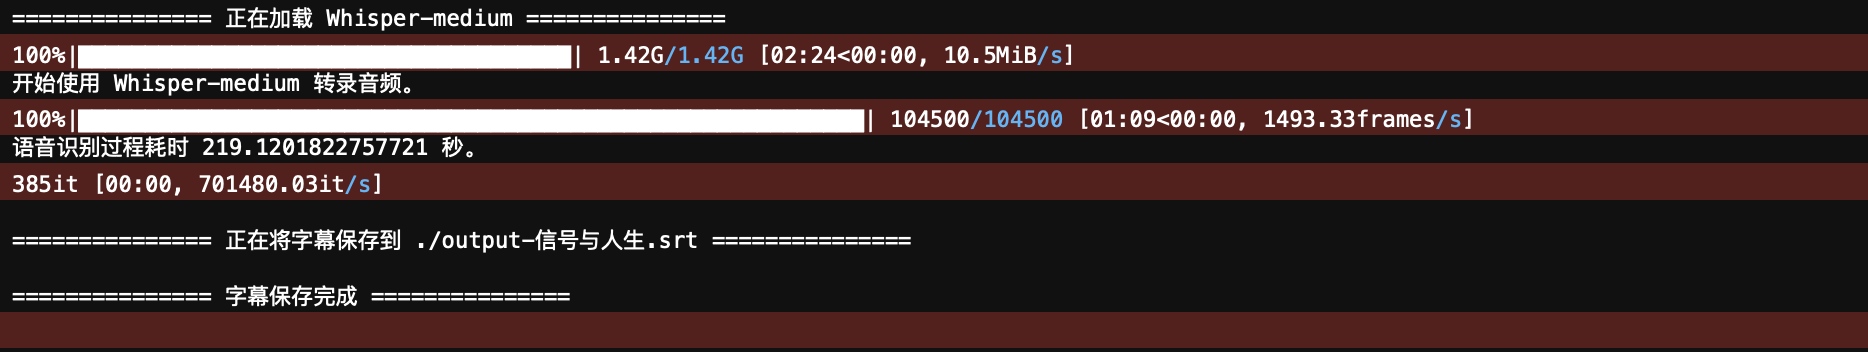
"预计需要花费 4 分钟时间(包括下载和识别,识别大概1分钟)(由模型大小,网速和你的显卡决定)\n",
"\n",
"**下载+识别**:\n",
"\n",
""
]
},
{
"cell_type": "code",
"execution_count": 9,
"id": "fb77f557-5acf-42c1-b887-9fad7b6b135b",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"=============== 正在加载 Whisper-medium ===============\n",
"=============== 正在转录音频 ===============\n"
]
},
{
"name": "stderr",
"output_type": "stream",
"text": [
"100%|██████████| 104500/104500 [01:41<00:00, 1027.59frames/s]\n"
]
},
{
"name": "stdout",
"output_type": "stream",
"text": [
"语音识别过程耗时 112.59942102432251 秒。\n"
]
},
{
"name": "stderr",
"output_type": "stream",
"text": [
"386it [00:00, 426614.32it/s]"
]
},
{
"name": "stdout",
"output_type": "stream",
"text": [
"\n",
"=============== 正在将字幕保存到 ./output-信号与人生.srt ===============\n",
"\n",
"=============== 字幕保存完成 ===============\n"
]
},
{
"name": "stderr",
"output_type": "stream",
"text": [
"\n"
]
}
],
"source": [
"# 运行 ASR\n",
"speech_recognition(model_name=model_name, input_audio=input_audio_array, output_subtitle_path=output_subtitle_path, decode_options=decode_options, cache_dir=cache_dir)"
]
},
{
"cell_type": "markdown",
"id": "1d1f09e8-baa0-4951-b91f-4c8c46161659",
"metadata": {},
"source": [
"**检查结果**"
]
},
{
"cell_type": "code",
"execution_count": 10,
"id": "3a69d62f-cf79-454f-a941-f491e13f9405",
"metadata": {
"scrolled": true
},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"1\n",
"00:00:00,000 --> 00:00:04,000\n",
"每次说学问是做出来的\n",
"\n",
"2\n",
"00:00:06,000 --> 00:00:08,000\n",
"什么意思?\n",
"\n",
"3\n",
"00:00:08,000 --> 00:00:12,000\n",
"要做才会获得学问\n",
"\n",
"4\n",
"00:00:13,000 --> 00:00:16,000\n",
"你如果每天光是坐在那里听\n",
"\n",
"5\n",
"00:00:17,000 --> 00:00:20,000\n",
"学问很可能是左耳进右耳出的\n",
"\n",
"6\n",
"00:00:21,000 --> 00:00:23,000\n",
"你光是坐在那儿读\n",
"\n",
"7\n",
"00:00:23,000 --> 00:00:26,000\n",
"学问可能从眼睛进入脑海之后就忘掉了\n",
"\n",
"8\n",
"00:00:26,000 --> 00:00:29,000\n",
"如何能够学问在脑海里面\n",
"\n",
"9\n",
"00:00:31,000 --> 00:00:33,000\n",
"真的变成你自己学问\n",
"\n",
"10\n",
"00:00:33,000 --> 00:00:35,000\n",
"就是要做\n",
"\n",
"11\n",
"00:00:36,000 --> 00:00:39,000\n",
"可能有很多同学有这个经验\n",
"\n",
"12\n",
"00:00:39,000 --> 00:00:41,000\n",
"你如果去修某一门课\n",
"\n",
"13\n",
"00:00:41,000 --> 00:00:44,000\n",
"或者做某一个实验\n",
"\n",
"14\n",
"00:00:44,000 --> 00:00:47,000\n",
"在期末就是要教一个final project\n",
"\n",
"15\n",
"00:00:48,000 --> 00:00:50,000\n",
"那个final project就是要你把\n",
"\n",
"16\n",
"00:00:51,000 --> 00:00:53,000\n",
"学到的很多东西\n",
"\n",
"17\n",
"00:00:53,000 --> 00:00:56,000\n",
"最后整合在你的final project里面\n",
"\n",
"18\n",
"00:00:56,000 --> 00:00:58,000\n",
"最后做出来的时候\n",
"\n",
"19\n",
"00:00:58,000 --> 00:01:00,000\n",
"就是把它们都整合了\n",
"\n",
"20\n",
"00:01:00,000 --> 00:01:02,000\n",
"当你学期结束\n",
"\n",
"21\n",
"00:01:02,000 --> 00:01:04,000\n",
"真的把final project做完的时候\n",
"\n",
"22\n",
"00:01:04,000 --> 00:01:05,000\n",
"你会忽然发现\n",
"\n",
"23\n",
"00:01:05,000 --> 00:01:07,000\n",
"我真的学到很多东西\n",
"\n",
"24\n",
"00:01:07,000 --> 00:01:10,000\n",
"那就是做出来的学问\n",
"\n",
"25\n",
"00:01:10,000 --> 00:01:12,000\n",
"也许有\n",
"\n",
"26\n",
"00:01:12,000 --> 00:01:13,000\n",
"可以举另外一个例子\n",
"\n",
"27\n",
"00:01:13,000 --> 00:01:14,000\n",
"就是你如果学了\n",
"\n",
"28\n",
"00:01:14,000 --> 00:01:17,000\n",
"某一些很复杂的演算法或者什么\n",
"\n",
"29\n",
"00:01:17,000 --> 00:01:21,000\n",
"好像觉得那些不见得在你的脑海里\n",
"\n",
"30\n",
"00:01:21,000 --> 00:01:24,000\n",
"可是后来老师出了个习题\n",
"\n",
"31\n",
"00:01:24,000 --> 00:01:26,000\n",
"那个习题叫你写一个很大的程式\n",
"\n",
"32\n",
"00:01:26,000 --> 00:01:28,000\n",
"要把所有东西都包进去\n",
"\n",
"33\n",
"00:01:28,000 --> 00:01:32,000\n",
"当你把这个程式写完的时候你会发现\n",
"\n",
"34\n",
"00:01:32,000 --> 00:01:35,000\n",
"你忽然把演算法你所有东西都弄通了\n",
"\n",
"35\n",
"00:01:35,000 --> 00:01:38,000\n",
"那就是学问是做出来的\n",
"\n",
"36\n",
"00:01:38,000 --> 00:01:40,000\n",
"所以我们永远要记得\n",
"\n",
"37\n",
"00:01:40,000 --> 00:01:44,000\n",
"尽量多动手多做\n",
"\n",
"38\n",
"00:01:44,000 --> 00:01:46,000\n",
"在动手跟做的过程之中\n",
"\n",
"39\n",
"00:01:46,000 --> 00:01:50,000\n",
"学问才可以变成是自己的\n",
"\n",
"40\n",
"00:01:50,000 --> 00:01:52,000\n",
"同样的情形就是说\n",
"\n",
"41\n",
"00:01:52,000 --> 00:01:55,000\n",
"很多时候这样动手或者做的\n",
"\n",
"42\n",
"00:01:55,000 --> 00:01:58,000\n",
"表现或者成绩\n",
"\n",
"43\n",
"00:01:58,000 --> 00:02:01,000\n",
"没有一个成绩单上的数字\n",
"\n",
"44\n",
"00:02:01,000 --> 00:02:04,000\n",
"使得很多人觉得那不重要\n",
"\n",
"45\n",
"00:02:04,000 --> 00:02:06,000\n",
"很多人甚至觉得\n",
"\n",
"46\n",
"00:02:06,000 --> 00:02:08,000\n",
"这门课要做final project\n",
"\n",
"47\n",
"00:02:08,000 --> 00:02:09,000\n",
"我就不修了太累了\n",
"\n",
"48\n",
"00:02:09,000 --> 00:02:11,000\n",
"或者说那门课需要\n",
"\n",
"49\n",
"00:02:11,000 --> 00:02:14,000\n",
"怎么样怎么样太累我就不要做了\n",
"\n",
"50\n",
"00:02:14,000 --> 00:02:15,000\n",
"而不知道\n",
"\n",
"51\n",
"00:02:15,000 --> 00:02:18,000\n",
"其实那个才是让你做的机会\n",
"\n",
"52\n",
"00:02:18,000 --> 00:02:20,000\n",
"然后可以学到最多\n",
"\n",
"53\n",
"00:02:20,000 --> 00:02:23,000\n",
"也就是说虽然很可能\n",
"\n",
"54\n",
"00:02:23,000 --> 00:02:26,000\n",
"那么辛苦的做很多事\n",
"\n",
"55\n",
"00:02:26,000 --> 00:02:29,000\n",
"没有让你获得什么具体成绩\n",
"\n",
"56\n",
"00:02:29,000 --> 00:02:31,000\n",
"对你的overfitting可能没有帮助\n",
"\n",
"57\n",
"00:02:31,000 --> 00:02:34,000\n",
"可是对你的全面学习是很有帮助\n",
"\n",
"58\n",
"00:02:34,000 --> 00:02:36,000\n",
"是该学的\n",
"\n",
"59\n",
"00:02:36,000 --> 00:02:39,000\n",
"不要漏掉这些事\n",
"\n",
"60\n",
"00:02:39,000 --> 00:02:42,000\n",
"这是我所说的\n",
"\n",
"61\n",
"00:02:42,000 --> 00:02:47,000\n",
"这个课业内可以做的这些事\n",
"\n",
"62\n",
"00:02:47,000 --> 00:02:50,000\n",
"刚才我们讲到思考的时候\n",
"\n",
"63\n",
"00:02:50,000 --> 00:02:53,000\n",
"我觉得我漏掉一点\n",
"\n",
"64\n",
"00:02:53,000 --> 00:02:55,000\n",
"你如果修我的信号课\n",
"\n",
"65\n",
"00:02:55,000 --> 00:02:57,000\n",
"你可能会发现\n",
"\n",
"66\n",
"00:02:57,000 --> 00:03:00,000\n",
"我上课没讲到一个数学式子的时候\n",
"\n",
"67\n",
"00:03:00,000 --> 00:03:02,000\n",
"我通常都不推他的\n",
"\n",
"68\n",
"00:03:02,000 --> 00:03:07,000\n",
"我是在解释那个数学式子在说什么话\n",
"\n",
"69\n",
"00:03:07,000 --> 00:03:10,000\n",
"同样的没讲到一个什么事情的时候\n",
"\n",
"70\n",
"00:03:10,000 --> 00:03:13,000\n",
"我通常就在解释他在说什么话\n",
"\n",
"71\n",
"00:03:13,000 --> 00:03:17,000\n",
"也就是说我在讲的就是\n",
"\n",
"72\n",
"00:03:17,000 --> 00:03:20,000\n",
"我读到课本那里的时候\n",
"\n",
"73\n",
"00:03:20,000 --> 00:03:22,000\n",
"我心里怎么想的\n",
"\n",
"74\n",
"00:03:22,000 --> 00:03:25,000\n",
"也就是我在告诉同学如何\n",
"\n",
"75\n",
"00:03:25,000 --> 00:03:28,000\n",
"这个读书的时候\n",
"\n",
"76\n",
"00:03:28,000 --> 00:03:31,000\n",
"如何一面读一面练习思考\n",
"\n",
"77\n",
"00:03:31,000 --> 00:03:35,000\n",
"这个才是最重要的一件事\n",
"\n",
"78\n",
"00:03:35,000 --> 00:03:40,000\n",
"如何培养自己思考的能力\n",
"\n",
"79\n",
"00:03:40,000 --> 00:03:42,000\n",
"跟培养思考的习惯\n",
"\n",
"80\n",
"00:03:42,000 --> 00:03:45,000\n",
"我觉得最好的办法就是\n",
"\n",
"81\n",
"00:03:45,000 --> 00:03:49,000\n",
"读书的时候凡是读到一个数学式子\n",
"\n",
"82\n",
"00:03:49,000 --> 00:03:50,000\n",
"都去想一想\n",
"\n",
"83\n",
"00:03:50,000 --> 00:03:53,000\n",
"那个数学式子到底在说什么\n",
"\n",
"84\n",
"00:03:53,000 --> 00:03:56,000\n",
"凡是读到课本上讲什么\n",
"\n",
"85\n",
"00:03:56,000 --> 00:03:57,000\n",
"就去想一想\n",
"\n",
"86\n",
"00:03:57,000 --> 00:03:59,000\n",
"那个到底在说什么\n",
"\n",
"87\n",
"00:03:59,000 --> 00:04:02,000\n",
"你要真的了解他在说什么的时候\n",
"\n",
"88\n",
"00:04:02,000 --> 00:04:03,000\n",
"你说什么时候\n",
"\n",
"89\n",
"00:04:03,000 --> 00:04:06,000\n",
"你就用了很多思考的功夫\n",
"\n",
"90\n",
"00:04:06,000 --> 00:04:10,000\n",
"你就在练习自己思考的能力了\n",
"\n",
"91\n",
"00:04:10,000 --> 00:04:11,000\n",
"好\n",
"\n",
"92\n",
"00:04:11,000 --> 00:04:15,000\n",
"以上说的是课业内的部分\n",
"\n",
"93\n",
"00:04:15,000 --> 00:04:18,000\n",
"那当然除了课业内之外\n",
"\n",
"94\n",
"00:04:18,000 --> 00:04:22,000\n",
"还有一大堆是不在课业内的\n",
"\n",
"95\n",
"00:04:22,000 --> 00:04:25,000\n",
"那就是课业外的\n",
"\n",
"96\n",
"00:04:25,000 --> 00:04:28,000\n",
"课业外也有很多式的\n",
"\n",
"97\n",
"00:04:28,000 --> 00:04:31,000\n",
"我们可以\n",
"\n",
"98\n",
"00:04:31,000 --> 00:04:34,000\n",
"举例来说\n",
"\n",
"99\n",
"00:04:38,000 --> 00:04:41,000\n",
"课业外有什么可以学习的\n",
"\n",
"100\n",
"00:04:41,000 --> 00:04:45,000\n",
"那我通常把学习定义成为\n",
"\n",
"101\n",
"00:04:45,000 --> 00:04:46,000\n",
"什么是学习\n",
"\n",
"102\n",
"00:04:46,000 --> 00:04:50,000\n",
"学习就是一种增长\n",
"\n",
"103\n",
"00:04:53,000 --> 00:04:56,000\n",
"一种进步\n",
"\n",
"104\n",
"00:04:56,000 --> 00:05:00,000\n",
"然后获得快乐\n",
"\n",
"105\n",
"00:05:00,000 --> 00:05:03,000\n",
"这就是学习\n",
"\n",
"106\n",
"00:05:03,000 --> 00:05:07,000\n",
"所以即使是课业外的任何事情\n",
"\n",
"107\n",
"00:05:07,000 --> 00:05:09,000\n",
"只要你觉得是有增长的\n",
"\n",
"108\n",
"00:05:09,000 --> 00:05:10,000\n",
"是有进步的\n",
"\n",
"109\n",
"00:05:10,000 --> 00:05:12,000\n",
"让你觉得快乐的\n",
"\n",
"110\n",
"00:05:12,000 --> 00:05:16,000\n",
"那应该就是值得学习的地方\n",
"\n",
"111\n",
"00:05:16,000 --> 00:05:19,000\n",
"那我们可以举很多例子\n",
"\n",
"112\n",
"00:05:19,000 --> 00:05:21,000\n",
"那譬如说\n",
"\n",
"113\n",
"00:05:21,000 --> 00:05:23,000\n",
"很多同学喜欢打球\n",
"\n",
"114\n",
"00:05:23,000 --> 00:05:26,000\n",
"打球是不是学习\n",
"\n",
"115\n",
"00:05:26,000 --> 00:05:27,000\n",
"当然是\n",
"\n",
"116\n",
"00:05:27,000 --> 00:05:29,000\n",
"在打球中间有没有增长\n",
"\n",
"117\n",
"00:05:29,000 --> 00:05:31,000\n",
"当然有增长\n",
"\n",
"118\n",
"00:05:31,000 --> 00:05:34,000\n",
"打球不只是对健康有增长\n",
"\n",
"119\n",
"00:05:34,000 --> 00:05:36,000\n",
"而且可能对于\n",
"\n",
"120\n",
"00:05:36,000 --> 00:05:38,000\n",
"譬如说手脑协调\n",
"\n",
"121\n",
"00:05:38,000 --> 00:05:40,000\n",
"譬如说团队精神\n",
"\n",
"122\n",
"00:05:40,000 --> 00:05:43,000\n",
"譬如说这个个人之间的互动\n",
"\n",
"123\n",
"00:05:43,000 --> 00:05:45,000\n",
"可能都有帮助\n",
"\n",
"124\n",
"00:05:45,000 --> 00:05:47,000\n",
"所以打球当然是有增长的\n",
"\n",
"125\n",
"00:05:47,000 --> 00:05:50,000\n",
"那当然是很好的学习的机会\n",
"\n",
"126\n",
"00:05:50,000 --> 00:05:52,000\n",
"有人喜欢爬山\n",
"\n",
"127\n",
"00:05:52,000 --> 00:05:54,000\n",
"爬山是不是好的学习机会\n",
"\n",
"128\n",
"00:05:54,000 --> 00:05:55,000\n",
"当然是\n",
"\n",
"129\n",
"00:05:55,000 --> 00:05:57,000\n",
"这个我以前两年前就讲过很多\n",
"\n",
"130\n",
"00:05:57,000 --> 00:05:59,000\n",
"爬山可以学到很多的\n",
"\n",
"131\n",
"00:05:59,000 --> 00:06:02,000\n",
"那爬山当然是一种学习\n",
"\n",
"132\n",
"00:06:02,000 --> 00:06:04,000\n",
"有人说我不喜欢爬山\n",
"\n",
"133\n",
"00:06:04,000 --> 00:06:05,000\n",
"我去旅行好不好\n",
"\n",
"134\n",
"00:06:05,000 --> 00:06:07,000\n",
"旅行当然好\n",
"\n",
"135\n",
"00:06:07,000 --> 00:06:09,000\n",
"旅行可以增长建设\n",
"\n",
"136\n",
"00:06:09,000 --> 00:06:11,000\n",
"可以扩增事业\n",
"\n",
"137\n",
"00:06:11,000 --> 00:06:13,000\n",
"可以增加很多很多\n",
"\n",
"138\n",
"00:06:13,000 --> 00:06:14,000\n",
"当然是有进步的\n",
"\n",
"139\n",
"00:06:14,000 --> 00:06:16,000\n",
"所以当然是很好的学习\n",
"\n",
"140\n",
"00:06:16,000 --> 00:06:18,000\n",
"你凡是获得快乐\n",
"\n",
"141\n",
"00:06:18,000 --> 00:06:20,000\n",
"都是很好的事\n",
"\n",
"142\n",
"00:06:20,000 --> 00:06:23,000\n",
"那这些都值得下功夫去\n",
"\n",
"143\n",
"00:06:23,000 --> 00:06:25,000\n",
"把它看成是学习\n",
"\n",
"144\n",
"00:06:25,000 --> 00:06:27,000\n",
"都值得下功夫去做的\n",
"\n",
"145\n",
"00:06:27,000 --> 00:06:29,000\n",
"我们再讲另外一系列\n",
"\n",
"146\n",
"00:06:29,000 --> 00:06:30,000\n",
"譬如说\n",
"\n",
"147\n",
"00:06:30,000 --> 00:06:34,000\n",
"有人说谈恋爱是不是学习\n",
"\n",
"148\n",
"00:06:34,000 --> 00:06:37,000\n",
"谈恋爱除了你在谈恋爱上\n",
"\n",
"149\n",
"00:06:37,000 --> 00:06:39,000\n",
"会有收获以外\n",
"\n",
"150\n",
"00:06:39,000 --> 00:06:41,000\n",
"本身也是有收获的\n",
"\n",
"151\n",
"00:06:41,000 --> 00:06:44,000\n",
"因为让你体验到人跟人之间\n",
"\n",
"152\n",
"00:06:44,000 --> 00:06:45,000\n",
"的各种感觉\n",
"\n",
"153\n",
"00:06:45,000 --> 00:06:48,000\n",
"人跟人之间的各种期待等等\n",
"\n",
"154\n",
"00:06:48,000 --> 00:06:50,000\n",
"有没有帮助\n",
"\n",
"155\n",
"00:06:50,000 --> 00:06:51,000\n",
"当然有帮助\n",
"\n",
"156\n",
"00:06:51,000 --> 00:06:53,000\n",
"有帮助对每一个人\n",
"\n",
"157\n",
"00:06:53,000 --> 00:06:54,000\n",
"都是很好的学习\n",
"\n",
"158\n",
"00:06:54,000 --> 00:06:57,000\n",
"所以谈恋爱当然是一件很好的事\n",
"\n",
"159\n",
"00:06:57,000 --> 00:06:59,000\n",
"那有人会说\n",
"\n",
"160\n",
"00:06:59,000 --> 00:07:01,000\n",
"那要靠缘分\n",
"\n",
"161\n",
"00:07:01,000 --> 00:07:02,000\n",
"没有缘分没有办法\n",
"\n",
"162\n",
"00:07:02,000 --> 00:07:03,000\n",
"对不对\n",
"\n",
"163\n",
"00:07:03,000 --> 00:07:04,000\n",
"对\n",
"\n",
"164\n",
"00:07:04,000 --> 00:07:06,000\n",
"但是你不是一定要谈恋爱吗\n",
"\n",
"165\n",
"00:07:06,000 --> 00:07:07,000\n",
"你可以交朋友\n",
"\n",
"166\n",
"00:07:07,000 --> 00:07:10,000\n",
"交朋友是不是学习\n",
"\n",
"167\n",
"00:07:10,000 --> 00:07:11,000\n",
"当然是\n",
"\n",
"168\n",
"00:07:11,000 --> 00:07:13,000\n",
"交朋友也一样\n",
"\n",
"169\n",
"00:07:13,000 --> 00:07:16,000\n",
"让我们学到很多人际的互动\n",
"\n",
"170\n",
"00:07:16,000 --> 00:07:20,000\n",
"学到很多人跟人之间的沟通\n",
"\n",
"171\n",
"00:07:20,000 --> 00:07:21,000\n",
"人跟人之间的期待\n",
"\n",
"172\n",
"00:07:21,000 --> 00:07:23,000\n",
"人跟人之间的感觉\n",
"\n",
"173\n",
"00:07:23,000 --> 00:07:26,000\n",
"这都是交朋友之后学到的\n",
"\n",
"174\n",
"00:07:26,000 --> 00:07:28,000\n",
"对我们电机系的同学而言\n",
"\n",
"175\n",
"00:07:28,000 --> 00:07:30,000\n",
"你四周有一大群好同学\n",
"\n",
"176\n",
"00:07:30,000 --> 00:07:33,000\n",
"都是很好的交朋友的对象\n",
"\n",
"177\n",
"00:07:33,000 --> 00:07:36,000\n",
"你下一番功夫交朋友好不好\n",
"\n",
"178\n",
"00:07:36,000 --> 00:07:37,000\n",
"好\n",
"\n",
"179\n",
"00:07:37,000 --> 00:07:40,000\n",
"当然是有帮助的\n",
"\n",
"180\n",
"00:07:40,000 --> 00:07:42,000\n",
"另外当然我们可以举很多\n",
"\n",
"181\n",
"00:07:42,000 --> 00:07:44,000\n",
"我们最现成的例子\n",
"\n",
"182\n",
"00:07:44,000 --> 00:07:47,000\n",
"譬如说我们的戏学会办各种活动\n",
"\n",
"183\n",
"00:07:47,000 --> 00:07:49,000\n",
"那些活动有没有帮助\n",
"\n",
"184\n",
"00:07:49,000 --> 00:07:50,000\n",
"当然有\n",
"\n",
"185\n",
"00:07:50,000 --> 00:07:54,000\n",
"那我们举例来讲电乐\n",
"\n",
"186\n",
"00:07:54,000 --> 00:07:56,000\n",
"你如果去参加某一个舞\n",
"\n",
"187\n",
"00:07:56,000 --> 00:07:57,000\n",
"跳个舞\n",
"\n",
"188\n",
"00:07:57,000 --> 00:08:00,000\n",
"或者参加某个剧演个剧\n",
"\n",
"189\n",
"00:08:00,000 --> 00:08:01,000\n",
"有没有帮助\n",
"\n",
"190\n",
"00:08:01,000 --> 00:08:02,000\n",
"当然有帮助\n",
"\n",
"191\n",
"00:08:02,000 --> 00:08:05,000\n",
"你在这中间一定发现有所增长\n",
"\n",
"192\n",
"00:08:05,000 --> 00:08:06,000\n",
"有所进步\n",
"\n",
"193\n",
"00:08:06,000 --> 00:08:09,000\n",
"那是为什么有那么多同学要去参加\n",
"\n",
"194\n",
"00:08:09,000 --> 00:08:13,000\n",
"就是因为发现那个确实是有增长有进步\n",
"\n",
"195\n",
"00:08:13,000 --> 00:08:15,000\n",
"那有的人说\n",
"\n",
"196\n",
"00:08:15,000 --> 00:08:20,000\n",
"我不去跳那个舞或者演那个剧\n",
"\n",
"197\n",
"00:08:20,000 --> 00:08:22,000\n",
"我做幕后的\n",
"\n",
"198\n",
"00:08:22,000 --> 00:08:25,000\n",
"譬如说是幕后的什么什么规划\n",
"\n",
"199\n",
"00:08:25,000 --> 00:08:29,000\n",
"或者说是什么这个光舞的什么软体组\n",
"\n",
"200\n",
"00:08:29,000 --> 00:08:32,000\n",
"还是什么这个服装道具组\n",
"\n",
"201\n",
"00:08:32,000 --> 00:08:33,000\n",
"一样啊\n",
"\n",
"202\n",
"00:08:33,000 --> 00:08:36,000\n",
"那个都是可以有获得很多的增长\n",
"\n",
"203\n",
"00:08:36,000 --> 00:08:37,000\n",
"很多进步的\n",
"\n",
"204\n",
"00:08:37,000 --> 00:08:39,000\n",
"当然都是很有用的\n",
"\n",
"205\n",
"00:08:39,000 --> 00:08:42,000\n",
"都是很好的学习\n",
"\n",
"206\n",
"00:08:42,000 --> 00:08:47,000\n",
"那当然也包括电业以外的戏学会\n",
"\n",
"207\n",
"00:08:47,000 --> 00:08:50,000\n",
"其他的各种活动都一样\n",
"\n",
"208\n",
"00:08:50,000 --> 00:08:56,000\n",
"也包括电机系以外的其他的校内或者\n",
"\n",
"209\n",
"00:08:56,000 --> 00:08:59,000\n",
"校外的各种活动几乎都一样\n",
"\n",
"210\n",
"00:08:59,000 --> 00:09:02,000\n",
"都可以让人有所增长有所进步\n",
"\n",
"211\n",
"00:09:02,000 --> 00:09:04,000\n",
"都是很好的学习的机会\n",
"\n",
"212\n",
"00:09:04,000 --> 00:09:06,000\n",
"都是很好的学习\n",
"\n",
"213\n",
"00:09:06,000 --> 00:09:10,000\n",
"同样的问题是这些东西都没有考试\n",
"\n",
"214\n",
"00:09:10,000 --> 00:09:14,000\n",
"没有成绩不能显示在成绩单上\n",
"\n",
"215\n",
"00:09:14,000 --> 00:09:18,000\n",
"因此对有一些同学会认为那个浪费时间\n",
"\n",
"216\n",
"00:09:18,000 --> 00:09:20,000\n",
"我不需要花时间去做那个\n",
"\n",
"217\n",
"00:09:20,000 --> 00:09:22,000\n",
"因为不影响我的\n",
"\n",
"218\n",
"00:09:22,000 --> 00:09:24,000\n",
"overfitting的目标\n",
"\n",
"219\n",
"00:09:24,000 --> 00:09:26,000\n",
"里面没有这个嘛\n",
"\n",
"220\n",
"00:09:26,000 --> 00:09:28,000\n",
"具体成绩没有这些嘛\n",
"\n",
"221\n",
"00:09:28,000 --> 00:09:30,000\n",
"那不要这样想\n",
"\n",
"222\n",
"00:09:30,000 --> 00:09:33,000\n",
"因为那些都非常的重要\n",
"\n",
"223\n",
"00:09:33,000 --> 00:09:36,000\n",
"都对你发展非常的重要\n",
"\n",
"224\n",
"00:09:36,000 --> 00:09:39,000\n",
"那我们说电机工程\n",
"\n",
"225\n",
"00:09:39,000 --> 00:09:42,000\n",
"今天的电机工程很少什么事情\n",
"\n",
"226\n",
"00:09:42,000 --> 00:09:44,000\n",
"自己一个人可以做成功的\n",
"\n",
"227\n",
"00:09:44,000 --> 00:09:47,000\n",
"你必须跟很多人一起\n",
"\n",
"228\n",
"00:09:47,000 --> 00:09:50,000\n",
"才可能做成功一个非常重要的\n",
"\n",
"229\n",
"00:09:50,000 --> 00:09:52,000\n",
"有意义的工作\n",
"\n",
"230\n",
"00:09:52,000 --> 00:09:55,000\n",
"那当你跟一群人在一起做的时候\n",
"\n",
"231\n",
"00:09:55,000 --> 00:09:59,000\n",
"你必须学会如何进入一个团队\n",
"\n",
"232\n",
"00:09:59,000 --> 00:10:03,000\n",
"从边缘开始慢慢进入核心\n",
"\n",
"233\n",
"00:10:03,000 --> 00:10:06,000\n",
"从底层开始慢慢变成leader\n",
"\n",
"234\n",
"00:10:06,000 --> 00:10:09,000\n",
"然后如何可以推动你想做的事\n",
"\n",
"235\n",
"00:10:09,000 --> 00:10:13,000\n",
"如何变成可以做到你想做的事等等\n",
"\n",
"236\n",
"00:10:13,000 --> 00:10:15,000\n",
"这些都是很重要的\n",
"\n",
"237\n",
"00:10:15,000 --> 00:10:18,000\n",
"那我们通常称这些东西\n",
"\n",
"238\n",
"00:10:18,000 --> 00:10:21,000\n",
"是所谓的soft skills\n",
"\n",
"239\n",
"00:10:21,000 --> 00:10:24,000\n",
"也就是软实力\n",
"\n",
"240\n",
"00:10:24,000 --> 00:10:30,000\n",
"所谓软实力就是硬实力以外的软实力\n",
"\n",
"241\n",
"00:10:30,000 --> 00:10:34,000\n",
"那硬实力是说你电子学的功力\n",
"\n",
"242\n",
"00:10:34,000 --> 00:10:36,000\n",
"数学的功力\n",
"\n",
"243\n",
"00:10:36,000 --> 00:10:39,000\n",
"这个城市能力这种是硬实力\n",
"\n",
"244\n",
"00:10:39,000 --> 00:10:44,000\n",
"软实力我们主要就是讲各种人际之间的\n",
"\n",
"245\n",
"00:10:44,000 --> 00:10:49,000\n",
"在人跟人之间的各种能力\n",
"\n",
"246\n",
"00:10:49,000 --> 00:10:51,000\n",
"包括沟通能力协调能力\n",
"\n",
"247\n",
"00:10:51,000 --> 00:10:53,000\n",
"交朋友的能力\n",
"\n",
"248\n",
"00:10:53,000 --> 00:10:55,000\n",
"这个说服人的能力\n",
"\n",
"249\n",
"00:10:55,000 --> 00:10:59,000\n",
"这个团队精神领导能力等等\n",
"\n",
"250\n",
"00:10:59,000 --> 00:11:02,000\n",
"那些就是所谓的soft skills\n",
"\n",
"251\n",
"00:11:02,000 --> 00:11:04,000\n",
"重要不重要重要\n",
"\n",
"252\n",
"00:11:04,000 --> 00:11:07,000\n",
"你看到任何一个成功的电机工程师\n",
"\n",
"253\n",
"00:11:07,000 --> 00:11:09,000\n",
"他都有一堆这种\n",
"\n",
"254\n",
"00:11:09,000 --> 00:11:13,000\n",
"这个才是他成功的一个非常重要的关键\n",
"\n",
"255\n",
"00:11:13,000 --> 00:11:15,000\n",
"这种东西怎么来\n",
"\n",
"256\n",
"00:11:15,000 --> 00:11:18,000\n",
"我们刚才讲的各种课业外的\n",
"\n",
"257\n",
"00:11:18,000 --> 00:11:20,000\n",
"各种学习增长的机会\n",
"\n",
"258\n",
"00:11:20,000 --> 00:11:26,000\n",
"都可以帮助一个人塑造他的soft skills\n",
"\n",
"259\n",
"00:11:26,000 --> 00:11:30,000\n",
"是有少数人的这些soft skills是天生的\n",
"\n",
"260\n",
"00:11:30,000 --> 00:11:31,000\n",
"他天生就厉害\n",
"\n",
"261\n",
"00:11:31,000 --> 00:11:32,000\n",
"有没有\n",
"\n",
"262\n",
"00:11:32,000 --> 00:11:33,000\n",
"有\n",
"\n",
"263\n",
"00:11:33,000 --> 00:11:35,000\n",
"但这种人毕竟没那么多\n",
"\n",
"264\n",
"00:11:35,000 --> 00:11:37,000\n",
"对很多人而言\n",
"\n",
"265\n",
"00:11:37,000 --> 00:11:42,000\n",
"他的soft skills是自己努力慢慢培养起来的\n",
"\n",
"266\n",
"00:11:42,000 --> 00:11:45,000\n",
"我刚才一开始前面讲的那一段\n",
"\n",
"267\n",
"00:11:45,000 --> 00:11:49,000\n",
"我说我在进台大电机系以前\n",
"\n",
"268\n",
"00:11:49,000 --> 00:11:51,000\n",
"我几乎不会交朋友\n",
"\n",
"269\n",
"00:11:51,000 --> 00:11:53,000\n",
"我不太会说话\n",
"\n",
"270\n",
"00:11:53,000 --> 00:11:57,000\n",
"我在读大学的四年里面改变我自己\n",
"\n",
"271\n",
"00:11:57,000 --> 00:12:02,000\n",
"让我变成有很多这方面的能力的人\n",
"\n",
"272\n",
"00:12:02,000 --> 00:12:06,000\n",
"其实最重要的就是我的很多soft skills\n",
"\n",
"273\n",
"00:12:06,000 --> 00:12:08,000\n",
"都是我自己培养\n",
"\n",
"274\n",
"00:12:08,000 --> 00:12:11,000\n",
"在读台大电机系的四年里面\n",
"\n",
"275\n",
"00:12:11,000 --> 00:12:15,000\n",
"获得的非常多这方面的收获的\n",
"\n",
"276\n",
"00:12:15,000 --> 00:12:21,000\n",
"那是为什么我每次都要强调这个东西有多么重要\n",
"\n",
"277\n",
"00:12:21,000 --> 00:12:29,000\n",
"那我之前曾经在几年前的这个信号与人生里面\n",
"\n",
"278\n",
"00:12:29,000 --> 00:12:31,000\n",
"有说到这一件事\n",
"\n",
"279\n",
"00:12:31,000 --> 00:12:33,000\n",
"我现在不要重复\n",
"\n",
"280\n",
"00:12:33,000 --> 00:12:36,000\n",
"但是我简单的summarize\n",
"\n",
"281\n",
"00:12:36,000 --> 00:12:39,000\n",
"那我说我们电机系的\n",
"\n",
"282\n",
"00:12:39,000 --> 00:12:45,000\n",
"电机工程师的一生career的发展\n",
"\n",
"283\n",
"00:12:45,000 --> 00:12:48,000\n",
"那黄金实在是在什么时候\n",
"\n",
"284\n",
"00:12:48,000 --> 00:12:52,000\n",
"我认为是在35岁到55岁\n",
"\n",
"285\n",
"00:12:52,000 --> 00:12:56,000\n",
"这20年是我们的黄金时代\n",
"\n",
"286\n",
"00:12:56,000 --> 00:12:58,000\n",
"在这以前当然更好\n",
"\n",
"287\n",
"00:12:58,000 --> 00:13:01,000\n",
"只是说可能各方面尚未具备\n",
"\n",
"288\n",
"00:13:01,000 --> 00:13:03,000\n",
"还没有完全训练的好\n",
"\n",
"289\n",
"00:13:03,000 --> 00:13:05,000\n",
"在这以后是最好的\n",
"\n",
"290\n",
"00:13:05,000 --> 00:13:10,000\n",
"这以后年纪大了难免有一些要打个折扣等等\n",
"\n",
"291\n",
"00:13:10,000 --> 00:13:15,000\n",
"就这里面我们看到我们的电机系的毕业的同学\n",
"\n",
"292\n",
"00:13:15,000 --> 00:13:18,000\n",
"过去有几千人毕业我都看到\n",
"\n",
"293\n",
"00:13:18,000 --> 00:13:22,000\n",
"那我觉得有的人的发展是像这样\n",
"\n",
"294\n",
"00:13:22,000 --> 00:13:24,000\n",
"有一定的斜率\n",
"\n",
"295\n",
"00:13:24,000 --> 00:13:28,000\n",
"但到某一个阶段它会慢慢saturate\n",
"\n",
"296\n",
"00:13:28,000 --> 00:13:31,000\n",
"有的人也许开始向上比较晚\n",
"\n",
"297\n",
"00:13:31,000 --> 00:13:33,000\n",
"但它斜率比较高\n",
"\n",
"298\n",
"00:13:33,000 --> 00:13:38,000\n",
"它最后会saturate在比较高的地方\n",
"\n",
"299\n",
"00:13:38,000 --> 00:13:41,000\n",
"也有的人也许开始的比较快\n",
"\n",
"300\n",
"00:13:41,000 --> 00:13:44,000\n",
"但是后来会overshoot之后\n",
"\n",
"301\n",
"00:13:44,000 --> 00:13:46,000\n",
"收敛在比较低的地方等等\n",
"\n",
"302\n",
"00:13:46,000 --> 00:13:48,000\n",
"这个每一个人都不一样\n",
"\n",
"303\n",
"00:13:48,000 --> 00:13:50,000\n",
"但是当然也有一种人\n",
"\n",
"304\n",
"00:13:50,000 --> 00:13:53,000\n",
"你会看到它一直向上走\n",
"\n",
"305\n",
"00:13:53,000 --> 00:13:57,000\n",
"完全没有saturate\n",
"\n",
"306\n",
"00:13:57,000 --> 00:14:01,000\n",
"这些人这些差别在哪里\n",
"\n",
"307\n",
"00:14:01,000 --> 00:14:03,000\n",
"这些东西差别在哪里\n",
"\n",
"308\n",
"00:14:03,000 --> 00:14:06,000\n",
"那我以前已经说过这件事\n",
"\n",
"309\n",
"00:14:06,000 --> 00:14:08,000\n",
"我不要多重复\n",
"\n",
"310\n",
"00:14:08,000 --> 00:14:10,000\n",
"我说最主要因素有四个\n",
"\n",
"311\n",
"00:14:10,000 --> 00:14:12,000\n",
"就是实力\n",
"\n",
"312\n",
"00:14:12,000 --> 00:14:14,000\n",
"努力\n",
"\n",
"313\n",
"00:14:16,000 --> 00:14:18,000\n",
"大智\n",
"\n",
"314\n",
"00:14:20,000 --> 00:14:23,000\n",
"跟self-deal这四件事情\n",
"\n",
"315\n",
"00:14:23,000 --> 00:14:25,000\n",
"那我认为\n",
"\n",
"316\n",
"00:14:26,000 --> 00:14:29,000\n",
"真正影响这个的\n",
"\n",
"317\n",
"00:14:29,000 --> 00:14:32,000\n",
"不是因为电子学考得好不好\n",
"\n",
"318\n",
"00:14:32,000 --> 00:14:35,000\n",
"不是因为信号与系统念得好不好\n",
"\n",
"319\n",
"00:14:35,000 --> 00:14:37,000\n",
"也就我刚才讲\n",
"\n",
"320\n",
"00:14:37,000 --> 00:14:41,000\n",
"你把每一门必修课当成是单一跑道\n",
"\n",
"321\n",
"00:14:41,000 --> 00:14:43,000\n",
"跑到第一名并不表示怎样\n",
"\n",
"322\n",
"00:14:43,000 --> 00:14:45,000\n",
"我们最后不看那个的\n",
"\n",
"323\n",
"00:14:45,000 --> 00:14:47,000\n",
"最后看的是这个\n",
"\n",
"324\n",
"00:14:47,000 --> 00:14:49,000\n",
"那这个是怎么样影响\n",
"\n",
"325\n",
"00:14:49,000 --> 00:14:51,000\n",
"我认为是这四件事\n",
"\n",
"326\n",
"00:14:51,000 --> 00:14:53,000\n",
"就是实力努力\n",
"\n",
"327\n",
"00:14:53,000 --> 00:14:55,000\n",
"大智跟self-skills\n",
"\n",
"328\n",
"00:14:56,000 --> 00:14:59,000\n",
"这四件事里面我们现在可以summarize\n",
"\n",
"329\n",
"00:14:59,000 --> 00:15:01,000\n",
"我刚才讲的\n",
"\n",
"330\n",
"00:15:01,000 --> 00:15:03,000\n",
"什么是实力\n",
"\n",
"331\n",
"00:15:03,000 --> 00:15:05,000\n",
"实力就是所有的这些\n",
"\n",
"332\n",
"00:15:05,000 --> 00:15:09,000\n",
"我们电机工程的专业领域里面的各种东西的实力\n",
"\n",
"333\n",
"00:15:09,000 --> 00:15:11,000\n",
"实力怎么厉害法\n",
"\n",
"334\n",
"00:15:11,000 --> 00:15:13,000\n",
"就是我刚才讲的\n",
"\n",
"335\n",
"00:15:13,000 --> 00:15:16,000\n",
"你如果都是在做全面的学习的话\n",
"\n",
"336\n",
"00:15:16,000 --> 00:15:18,000\n",
"你就会学到各种该学到的\n",
"\n",
"337\n",
"00:15:18,000 --> 00:15:20,000\n",
"最后你的实力就是很强的\n",
"\n",
"338\n",
"00:15:20,000 --> 00:15:25,000\n",
"所以实力最主要就是不要overfitting\n",
"\n",
"339\n",
"00:15:25,000 --> 00:15:31,000\n",
"要尽量都做学到该学的全面的学习\n",
"\n",
"340\n",
"00:15:31,000 --> 00:15:33,000\n",
"努力是没有疑问\n",
"\n",
"341\n",
"00:15:33,000 --> 00:15:35,000\n",
"每个人都了解\n",
"\n",
"342\n",
"00:15:35,000 --> 00:15:38,000\n",
"确实我们可以看到一个人在未来的几十年里面\n",
"\n",
"343\n",
"00:15:38,000 --> 00:15:40,000\n",
"有的人他一直努力\n",
"\n",
"344\n",
"00:15:40,000 --> 00:15:42,000\n",
"有的人慢慢不太努力等等\n",
"\n",
"345\n",
"00:15:42,000 --> 00:15:44,000\n",
"这个是有明显差别的\n",
"\n",
"346\n",
"00:15:44,000 --> 00:15:46,000\n",
"那self-skills我刚才已经讲了\n",
"\n",
"347\n",
"00:15:46,000 --> 00:15:50,000\n",
"就是很多我们平常没有算成绩\n",
"\n",
"348\n",
"00:15:50,000 --> 00:15:52,000\n",
"觉得大家不重视的事情\n",
"\n",
"349\n",
"00:15:52,000 --> 00:15:54,000\n",
"那其他常常是很重要的\n",
"\n",
"350\n",
"00:15:54,000 --> 00:15:56,000\n",
"你如果好好的\n",
"\n",
"351\n",
"00:15:56,000 --> 00:15:59,000\n",
"多在各种课业外的事情上\n",
"\n",
"352\n",
"00:15:59,000 --> 00:16:01,000\n",
"增长进步的话\n",
"\n",
"353\n",
"00:16:01,000 --> 00:16:03,000\n",
"你这个东西会很强\n",
"\n",
"354\n",
"00:16:03,000 --> 00:16:05,000\n",
"这个东西会很厉害的\n",
"\n",
"355\n",
"00:16:05,000 --> 00:16:07,000\n",
"当然对少数人而言\n",
"\n",
"356\n",
"00:16:07,000 --> 00:16:08,000\n",
"他天生就有\n",
"\n",
"357\n",
"00:16:08,000 --> 00:16:09,000\n",
"他可能不需要\n",
"\n",
"358\n",
"00:16:09,000 --> 00:16:11,000\n",
"就是每一个人不一样的\n",
"\n",
"359\n",
"00:16:11,000 --> 00:16:13,000\n",
"那这三个我都提过了\n",
"\n",
"360\n",
"00:16:13,000 --> 00:16:15,000\n",
"那么大致我还没有提\n",
"\n",
"361\n",
"00:16:15,000 --> 00:16:18,000\n",
"其实大致没有什么要特别说的\n",
"\n",
"362\n",
"00:16:18,000 --> 00:16:21,000\n",
"那应该就是我刚才前面有讲过\n",
"\n",
"363\n",
"00:16:21,000 --> 00:16:25,000\n",
"就是每一个人可以有你自己的长程目标\n",
"\n",
"364\n",
"00:16:25,000 --> 00:16:28,000\n",
"那有的人本来就有了\n",
"\n",
"365\n",
"00:16:28,000 --> 00:16:31,000\n",
"有的人也许我平常没有想过\n",
"\n",
"366\n",
"00:16:31,000 --> 00:16:35,000\n",
"那你可以在适当时机开始想\n",
"\n",
"367\n",
"00:16:35,000 --> 00:16:38,000\n",
"我有没有想要做什么事情\n",
"\n",
"368\n",
"00:16:38,000 --> 00:16:41,000\n",
"哪些事情可能是我的长程目标\n",
"\n",
"369\n",
"00:16:41,000 --> 00:16:46,000\n",
"我希望最后让我花个五年十年\n",
"\n",
"370\n",
"00:16:46,000 --> 00:16:48,000\n",
"十五年或者更长\n",
"\n",
"371\n",
"00:16:48,000 --> 00:16:50,000\n",
"我把我的很多的努力\n",
"\n",
"372\n",
"00:16:50,000 --> 00:16:53,000\n",
"都来把某些事情做得非常漂亮\n",
"\n",
"373\n",
"00:16:53,000 --> 00:16:55,000\n",
"那是我很想做的事\n",
"\n",
"374\n",
"00:16:55,000 --> 00:16:57,000\n",
"那就是长程目标\n",
"\n",
"375\n",
"00:16:57,000 --> 00:16:59,000\n",
"如果我觉得做那些事情\n",
"\n",
"376\n",
"00:16:59,000 --> 00:17:01,000\n",
"会让我非常的\n",
"\n",
"377\n",
"00:17:01,000 --> 00:17:03,000\n",
"觉得有意义\n",
"\n",
"378\n",
"00:17:03,000 --> 00:17:05,000\n",
"愿意花功夫下去做的\n",
"\n",
"379\n",
"00:17:05,000 --> 00:17:07,000\n",
"那就是我的长程目标\n",
"\n",
"380\n",
"00:17:07,000 --> 00:17:10,000\n",
"那有的人如果可以想出这个来的话\n",
"\n",
"381\n",
"00:17:10,000 --> 00:17:13,000\n",
"那就是他的大致\n",
"\n",
"382\n",
"00:17:13,000 --> 00:17:15,000\n",
"那越是有这种大致的人\n",
"\n",
"383\n",
"00:17:15,000 --> 00:17:18,000\n",
"也比较容易向上冲\n",
"\n",
"384\n",
"00:17:18,000 --> 00:17:19,000\n",
"那我感觉起来\n",
"\n",
"385\n",
"00:17:19,000 --> 00:17:23,000\n",
"真正影响的就是这四件事\n",
"\n",
"386\n",
"00:17:23,000 --> 00:17:33,000\n",
"请不吝点赞 订阅 转发 打赏支持明镜与点点栏目\n",
"\n",
"\n"
]
}
],
"source": [
"'''\n",
"打开 SRT 文件并读取其内容。\n",
"SRT 文件格式为:\n",
"\n",
"[索引]\n",
"[开始时间] (小时:分钟:秒) --> [结束时间] (小时:分钟:秒)\n",
"[转录内容]\n",
"'''\n",
"\n",
"with open(output_subtitle_path, 'r', encoding='utf-8') as file:\n",
" content = file.read()\n",
"\n",
"print(content)"
]
},
{
"cell_type": "code",
"execution_count": 11,
"id": "bc74a4c9-73d0-4b70-b089-9ff861c5dbd6",
"metadata": {},
"outputs": [],
"source": [
"def extract_and_save_text(srt_filename, output_filename, convert_to_tradition_chinese=False):\n",
" \"\"\"\n",
" 提取SRT文件中的文本并将其保存到新的文本文件中。\n",
" \n",
" 如果 convert_to_tradition_chinese 为 True,则将简体中文转换为繁体中文。\n",
" \n",
" 参数:\n",
" srt_filename: SRT文件的路径\n",
" output_filename: 输出文本文件的名称\n",
" convert_to_tradition_chinese: 布尔值,指示是否将简体中文转换为繁体中文。默认值为 False\n",
" \n",
" 示例:\n",
" 如果你的SRT文件名为 'subtitle.srt',并且希望将提取的文本保存为名为 'output.txt' 的文件,不进行简繁转换,可以按如下方式使用该函数:\n",
" extract_and_save_text('subtitle.srt', 'output.txt')\n",
" \n",
" 如果需要将简体中文转换为繁体中文,可以设置 convert_to_tradition_chinese=True:\n",
" extract_and_save_text('subtitle.srt', 'output.txt', convert_to_tradition_chinese=True)\n",
" \"\"\"\n",
"\n",
" # 打开SRT文件并读取其内容\n",
" with open(srt_filename, 'r', encoding='utf-8') as file:\n",
" content = file.read()\n",
"\n",
" # 使用正则表达式去除时间码\n",
" pure_text = re.sub(r'\\d+\\n\\d{2}:\\d{2}:\\d{2},\\d{3} --> \\d{2}:\\d{2}:\\d{2},\\d{3}\\n', '', content)\n",
"\n",
" # 去除空行\n",
" pure_text = re.sub(r'\\n\\n+', '\\n', pure_text)\n",
"\n",
" # 如果需要转换为繁体中文\n",
" if convert_to_tradition_chinese:\n",
" import opencc\n",
" converter = opencc.OpenCC('s2t') # s2t:简体到繁体(Traditional Chinese, Taiwan standard)\n",
" pure_text = converter.convert(pure_text)\n",
"\n",
" # 将纯文本保存到新文件\n",
" with open(output_filename, 'w', encoding='utf-8') as output_file:\n",
" output_file.write(pure_text)\n",
"\n",
" print(f'提取的文本已保存到 {output_filename}')\n",
"\n",
" return pure_text"
]
},
{
"cell_type": "markdown",
"id": "dc8dca8e-46ed-430f-bdd6-b514d16cfb81",
"metadata": {},
"source": [
"## 第3部分 - 处理自动语音识别的结果\n",
"\n"
]
},
{
"cell_type": "code",
"execution_count": 12,
"id": "65936d9d-7e43-4978-9295-eb4bfbca47dc",
"metadata": {},
"outputs": [],
"source": [
"def chunk_text(text, max_length):\n",
" \"\"\"\n",
" 将长字符串拆分为指定长度的较小字符串。\n",
" \n",
" 参数:\n",
" text: 要拆分的长字符串\n",
" max_length: 每个较小字符串的最大长度\n",
" \n",
" 返回:\n",
" 拆分后的字符串列表\n",
" \n",
" 示例:\n",
" 如果你想将一个名为 \"long_string\" 的字符串拆分为长度为 100 的较小字符串,可以按如下方式使用该函数:\n",
" chunk_text(long_string, 100)\n",
" \"\"\"\n",
"\n",
" return textwrap.wrap(text, max_length)"
]
},
{
"cell_type": "markdown",
"id": "9d74e1f3-1dc6-4801-bc98-0640b3d3fb90",
"metadata": {},
"source": [
"这里可以自定义修改文本块参数,修改后执行下一段代码查看结果。\n",
"\n",
"如果你更偏好繁体,修改 convert_to_tradition_chinese = True。"
]
},
{
"cell_type": "code",
"execution_count": 13,
"id": "c99846f4-87c7-4702-90a1-f67a327a9c17",
"metadata": {},
"outputs": [],
"source": [
"# 文本块的长度\n",
"chunk_length = 512\n",
"\n",
"# 决定是否转为繁体\n",
"convert_to_tradition_chinese = False"
]
},
{
"cell_type": "code",
"execution_count": 14,
"id": "2bc48dbb-664c-49c8-b6bd-a1b3bb09e135",
"metadata": {
"scrolled": true
},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"提取的文本已保存到 ./output-信号与人生.txt\n",
"查看将长文本拆分为多个短文本的结果。\n",
"\n",
"\n",
"========== 拆分后的第 1 段(506 字) ==========\n",
"\n",
"\n",
"每次说学问是做出来的 什么意思? 要做才会获得学问 你如果每天光是坐在那里听 学问很可能是左耳进右耳出的 你光是坐在那儿读 学问可能从眼睛进入脑海之后就忘掉了\n",
"\n",
"如何能够学问在脑海里面 真的变成你自己学问 就是要做 可能有很多同学有这个经验 你如果去修某一门课 或者做某一个实验 在期末就是要教一个final\n",
"\n",
"project 那个final project就是要你把 学到的很多东西 最后整合在你的final project里面 最后做出来的时候 就是把它们都整合了\n",
"\n",
"当你学期结束 真的把final project做完的时候 你会忽然发现 我真的学到很多东西 那就是做出来的学问 也许有 可以举另外一个例子 就是你如果学了\n",
"\n",
"某一些很复杂的演算法或者什么 好像觉得那些不见得在你的脑海里 可是后来老师出了个习题 那个习题叫你写一个很大的程式 要把所有东西都包进去\n",
"\n",
"当你把这个程式写完的时候你会发现 你忽然把演算法你所有东西都弄通了 那就是学问是做出来的 所以我们永远要记得 尽量多动手多做 在动手跟做的过程之中\n",
"\n",
"学问才可以变成是自己的 同样的情形就是说 很多时候这样动手或者做的 表现或者成绩 没有一个成绩单上的数字\n",
"\n",
"\n",
"========== 拆分后的第 2 段(511 字) ==========\n",
"\n",
"\n",
"使得很多人觉得那不重要 很多人甚至觉得 这门课要做final project 我就不修了太累了 或者说那门课需要 怎么样怎么样太累我就不要做了 而不知道\n",
"\n",
"其实那个才是让你做的机会 然后可以学到最多 也就是说虽然很可能 那么辛苦的做很多事 没有让你获得什么具体成绩 对你的overfitting可能没有帮助\n",
"\n",
"可是对你的全面学习是很有帮助 是该学的 不要漏掉这些事 这是我所说的 这个课业内可以做的这些事 刚才我们讲到思考的时候 我觉得我漏掉一点 你如果修我的信号课\n",
"\n",
"你可能会发现 我上课没讲到一个数学式子的时候 我通常都不推他的 我是在解释那个数学式子在说什么话 同样的没讲到一个什么事情的时候 我通常就在解释他在说什么话\n",
"\n",
"也就是说我在讲的就是 我读到课本那里的时候 我心里怎么想的 也就是我在告诉同学如何 这个读书的时候 如何一面读一面练习思考 这个才是最重要的一件事\n",
"\n",
"如何培养自己思考的能力 跟培养思考的习惯 我觉得最好的办法就是 读书的时候凡是读到一个数学式子 都去想一想 那个数学式子到底在说什么 凡是读到课本上讲什么\n",
"\n",
"就去想一想 那个到底在说什么 你要真的了解他在说什么的时候 你说什么时候 你就用了很多思考的功夫\n",
"\n",
"\n",
"========== 拆分后的第 3 段(506 字) ==========\n",
"\n",
"\n",
"你就在练习自己思考的能力了 好 以上说的是课业内的部分 那当然除了课业内之外 还有一大堆是不在课业内的 那就是课业外的 课业外也有很多式的 我们可以 举例来说\n",
"\n",
"课业外有什么可以学习的 那我通常把学习定义成为 什么是学习 学习就是一种增长 一种进步 然后获得快乐 这就是学习 所以即使是课业外的任何事情\n",
"\n",
"只要你觉得是有增长的 是有进步的 让你觉得快乐的 那应该就是值得学习的地方 那我们可以举很多例子 那譬如说 很多同学喜欢打球 打球是不是学习 当然是\n",
"\n",
"在打球中间有没有增长 当然有增长 打球不只是对健康有增长 而且可能对于 譬如说手脑协调 譬如说团队精神 譬如说这个个人之间的互动 可能都有帮助\n",
"\n",
"所以打球当然是有增长的 那当然是很好的学习的机会 有人喜欢爬山 爬山是不是好的学习机会 当然是 这个我以前两年前就讲过很多 爬山可以学到很多的\n",
"\n",
"那爬山当然是一种学习 有人说我不喜欢爬山 我去旅行好不好 旅行当然好 旅行可以增长建设 可以扩增事业 可以增加很多很多 当然是有进步的 所以当然是很好的学习\n",
"\n",
"你凡是获得快乐 都是很好的事 那这些都值得下功夫去 把它看成是学习 都值得下功夫去做的 我们再讲另外一系列 譬如说\n",
"\n",
"\n",
"========== 拆分后的第 4 段(504 字) ==========\n",
"\n",
"\n",
"有人说谈恋爱是不是学习 谈恋爱除了你在谈恋爱上 会有收获以外 本身也是有收获的 因为让你体验到人跟人之间 的各种感觉 人跟人之间的各种期待等等 有没有帮助\n",
"\n",
"当然有帮助 有帮助对每一个人 都是很好的学习 所以谈恋爱当然是一件很好的事 那有人会说 那要靠缘分 没有缘分没有办法 对不对 对 但是你不是一定要谈恋爱吗\n",
"\n",
"你可以交朋友 交朋友是不是学习 当然是 交朋友也一样 让我们学到很多人际的互动 学到很多人跟人之间的沟通 人跟人之间的期待 人跟人之间的感觉\n",
"\n",
"这都是交朋友之后学到的 对我们电机系的同学而言 你四周有一大群好同学 都是很好的交朋友的对象 你下一番功夫交朋友好不好 好 当然是有帮助的\n",
"\n",
"另外当然我们可以举很多 我们最现成的例子 譬如说我们的戏学会办各种活动 那些活动有没有帮助 当然有 那我们举例来讲电乐 你如果去参加某一个舞 跳个舞\n",
"\n",
"或者参加某个剧演个剧 有没有帮助 当然有帮助 你在这中间一定发现有所增长 有所进步 那是为什么有那么多同学要去参加 就是因为发现那个确实是有增长有进步\n",
"\n",
"那有的人说 我不去跳那个舞或者演那个剧 我做幕后的 譬如说是幕后的什么什么规划 或者说是什么这个光舞的什么软体组\n",
"\n",
"\n",
"========== 拆分后的第 5 段(505 字) ==========\n",
"\n",
"\n",
"还是什么这个服装道具组 一样啊 那个都是可以有获得很多的增长 很多进步的 当然都是很有用的 都是很好的学习 那当然也包括电业以外的戏学会 其他的各种活动都一样\n",
"\n",
"也包括电机系以外的其他的校内或者 校外的各种活动几乎都一样 都可以让人有所增长有所进步 都是很好的学习的机会 都是很好的学习 同样的问题是这些东西都没有考试\n",
"\n",
"没有成绩不能显示在成绩单上 因此对有一些同学会认为那个浪费时间 我不需要花时间去做那个 因为不影响我的 overfitting的目标 里面没有这个嘛\n",
"\n",
"具体成绩没有这些嘛 那不要这样想 因为那些都非常的重要 都对你发展非常的重要 那我们说电机工程 今天的电机工程很少什么事情 自己一个人可以做成功的\n",
"\n",
"你必须跟很多人一起 才可能做成功一个非常重要的 有意义的工作 那当你跟一群人在一起做的时候 你必须学会如何进入一个团队 从边缘开始慢慢进入核心\n",
"\n",
"从底层开始慢慢变成leader 然后如何可以推动你想做的事 如何变成可以做到你想做的事等等 这些都是很重要的 那我们通常称这些东西 是所谓的soft\n",
"\n",
"skills 也就是软实力 所谓软实力就是硬实力以外的软实力 那硬实力是说你电子学的功力 数学的功力\n",
"\n",
"\n",
"========== 拆分后的第 6 段(506 字) ==========\n",
"\n",
"\n",
"这个城市能力这种是硬实力 软实力我们主要就是讲各种人际之间的 在人跟人之间的各种能力 包括沟通能力协调能力 交朋友的能力 这个说服人的能力\n",
"\n",
"这个团队精神领导能力等等 那些就是所谓的soft skills 重要不重要重要 你看到任何一个成功的电机工程师 他都有一堆这种\n",
"\n",
"这个才是他成功的一个非常重要的关键 这种东西怎么来 我们刚才讲的各种课业外的 各种学习增长的机会 都可以帮助一个人塑造他的soft skills\n",
"\n",
"是有少数人的这些soft skills是天生的 他天生就厉害 有没有 有 但这种人毕竟没那么多 对很多人而言 他的soft skills是自己努力慢慢培养起来的\n",
"\n",
"我刚才一开始前面讲的那一段 我说我在进台大电机系以前 我几乎不会交朋友 我不太会说话 我在读大学的四年里面改变我自己 让我变成有很多这方面的能力的人\n",
"\n",
"其实最重要的就是我的很多soft skills 都是我自己培养 在读台大电机系的四年里面 获得的非常多这方面的收获的 那是为什么我每次都要强调这个东西有多么重要\n",
"\n",
"那我之前曾经在几年前的这个信号与人生里面 有说到这一件事 我现在不要重复 但是我简单的summarize 那我说我们电机系的\n",
"\n",
"\n",
"========== 拆分后的第 7 段(511 字) ==========\n",
"\n",
"\n",
"电机工程师的一生career的发展 那黄金实在是在什么时候 我认为是在35岁到55岁 这20年是我们的黄金时代 在这以前当然更好 只是说可能各方面尚未具备\n",
"\n",
"还没有完全训练的好 在这以后是最好的 这以后年纪大了难免有一些要打个折扣等等 就这里面我们看到我们的电机系的毕业的同学 过去有几千人毕业我都看到\n",
"\n",
"那我觉得有的人的发展是像这样 有一定的斜率 但到某一个阶段它会慢慢saturate 有的人也许开始向上比较晚 但它斜率比较高\n",
"\n",
"它最后会saturate在比较高的地方 也有的人也许开始的比较快 但是后来会overshoot之后 收敛在比较低的地方等等 这个每一个人都不一样\n",
"\n",
"但是当然也有一种人 你会看到它一直向上走 完全没有saturate 这些人这些差别在哪里 这些东西差别在哪里 那我以前已经说过这件事 我不要多重复\n",
"\n",
"我说最主要因素有四个 就是实力 努力 大智 跟self-deal这四件事情 那我认为 真正影响这个的 不是因为电子学考得好不好 不是因为信号与系统念得好不好\n",
"\n",
"也就我刚才讲 你把每一门必修课当成是单一跑道 跑到第一名并不表示怎样 我们最后不看那个的 最后看的是这个 那这个是怎么样影响 我认为是这四件事\n",
"\n",
"\n",
"========== 拆分后的第 8 段(510 字) ==========\n",
"\n",
"\n",
"就是实力努力 大智跟self-skills 这四件事里面我们现在可以summarize 我刚才讲的 什么是实力 实力就是所有的这些\n",
"\n",
"我们电机工程的专业领域里面的各种东西的实力 实力怎么厉害法 就是我刚才讲的 你如果都是在做全面的学习的话 你就会学到各种该学到的 最后你的实力就是很强的\n",
"\n",
"所以实力最主要就是不要overfitting 要尽量都做学到该学的全面的学习 努力是没有疑问 每个人都了解 确实我们可以看到一个人在未来的几十年里面\n",
"\n",
"有的人他一直努力 有的人慢慢不太努力等等 这个是有明显差别的 那self-skills我刚才已经讲了 就是很多我们平常没有算成绩 觉得大家不重视的事情\n",
"\n",
"那其他常常是很重要的 你如果好好的 多在各种课业外的事情上 增长进步的话 你这个东西会很强 这个东西会很厉害的 当然对少数人而言 他天生就有 他可能不需要\n",
"\n",
"就是每一个人不一样的 那这三个我都提过了 那么大致我还没有提 其实大致没有什么要特别说的 那应该就是我刚才前面有讲过 就是每一个人可以有你自己的长程目标\n",
"\n",
"那有的人本来就有了 有的人也许我平常没有想过 那你可以在适当时机开始想 我有没有想要做什么事情 哪些事情可能是我的长程目标\n",
"\n",
"\n",
"========== 拆分后的第 9 段(193 字) ==========\n",
"\n",
"\n",
"我希望最后让我花个五年十年 十五年或者更长 我把我的很多的努力 都来把某些事情做得非常漂亮 那是我很想做的事 那就是长程目标 如果我觉得做那些事情 会让我非常的\n",
"\n",
"觉得有意义 愿意花功夫下去做的 那就是我的长程目标 那有的人如果可以想出这个来的话 那就是他的大致 那越是有这种大致的人 也比较容易向上冲 那我感觉起来\n",
"\n",
"真正影响的就是这四件事 请不吝点赞 订阅 转发 打赏支持明镜与点点栏目\n",
"\n"
]
}
],
"source": [
"# 从SRT文件中提取文本并保存为新文本文件\n",
"pure_text = extract_and_save_text(srt_filename=output_subtitle_path, output_filename=output_raw_text_path, convert_to_tradition_chinese=convert_to_tradition_chinese)\n",
"\n",
"# 将长文本拆分为指定长度的较小块\n",
"chunks = chunk_text(text=pure_text, max_length=512)\n",
"\n",
"# 你可以查看每段的字数和内容\n",
"print(\"查看将长文本拆分为多个短文本的结果。\\n\")\n",
"for index, chunk in enumerate(chunks):\n",
" if index == 0:\n",
" print(f\"\\n========== 拆分后的第 {index + 1} 段({len(chunk)} 字) ==========\\n\\n\")\n",
" for text in textwrap.wrap(chunk, 80):\n",
" print(f\"{text}\\n\")\n",
" elif index == 1:\n",
" print(f\"\\n========== 拆分后的第 {index + 1} 段({len(chunk)} 字) ==========\\n\\n\")\n",
" for text in textwrap.wrap(chunk, 80):\n",
" print(f\"{text}\\n\")\n",
" elif index == 2:\n",
" print(f\"\\n========== 拆分后的第 {index + 1} 段({len(chunk)} 字) ==========\\n\\n\")\n",
" for text in textwrap.wrap(chunk, 80):\n",
" print(f\"{text}\\n\")\n",
" else:\n",
" print(f\"\\n========== 拆分后的第 {index + 1} 段({len(chunk)} 字) ==========\\n\\n\")\n",
" for text in textwrap.wrap(chunk, 80):\n",
" print(f\"{text}\\n\")"
]
},
{
"cell_type": "markdown",
"id": "a43b6c25-df8b-4339-b2f0-217e81543ac2",
"metadata": {},
"source": [
"## 第4部分 - 摘要\n",
"\n",
"这里提供的方法同 ChatGPT,因为一样使用 OpenAI 库进行。\n",
"\n",
"你可以通过[《00. 大模型 API 获取步骤》](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/Guide/00.%20大模型%20API%20获取步骤.md)获取 API 密钥。\n",
"\n",
"其他模型可以参阅[模型广场 -- 阿里云百炼](https://bailian.console.aliyun.com/?spm=5176.29619931.J__Z58Z6CX7MY__Ll8p1ZOR.1.4d1d59fcWwSqvr#/model-market),点击对应模型的`查看详情`。\n",
"\n",
"\n",
"\n",
"在界面左上角可以看到对应的英文名称。\n",
"\n",
"\n",
"\n",
"复制它。\n",
"\n",
"现在你可以随意更换为你想要的模型,不过你可能要先申请使用(通过大概要几个小时,会有短信提示)。"
]
},
{
"cell_type": "code",
"execution_count": 15,
"id": "374d7006-e3f5-420f-9a25-58ab554105ee",
"metadata": {},
"outputs": [],
"source": [
"def summarization(client, summarization_prompt, model_name=\"qwen-plus\", temperature=0.0, top_p=1.0, max_tokens=512):\n",
" \"\"\"\n",
" 使用 OpenAI Chat API 对给定文本进行摘要。\n",
" \n",
" 参数:\n",
" client: OpenAI Chat API客户端\n",
" summarization_prompt: 包含需要摘要的文本的摘要prompt\n",
" model_name: 模型名称,默认是 \"qwen-plus\"\n",
" temperature: 控制响应的随机性。较低的值使响应更具确定性,默认是 0.0\n",
" top_p: 通过核采样控制多样性。较高的值会导致更多样化的响应,默认是 1.0\n",
" max_tokens: 完成任务时生成的最大tokens,默认是 512\n",
" \n",
" 返回:\n",
" 摘要文本\n",
" \n",
" 示例:\n",
" 如果文本是 \"ABC\",摘要prompt是 \"DEF\",model_name 是 \"qwen-plus\",temperature 是 0.0,top_p 是 1.0,max_tokens 是 512,则可以按如下方式调用此函数:\n",
" \n",
" summarization(client=client, text=\"ABC\", summarization_prompt=\"DEF\", model_name=\"qwen-plus\", temperature=0.0, top_p=1.0, max_tokens=512)\n",
" \"\"\"\n",
"\n",
" # 用户prompt是 summarization_prompt 和文本的结合\n",
" user_prompt = summarization_prompt\n",
"\n",
" while True:\n",
"\n",
" try:\n",
" # 使用 OpenAI Chat API 对文本进行摘要\n",
" chat_completion = client.chat.completions.create(\n",
" messages=[\n",
" {\n",
" \"role\": \"user\",\n",
" \"content\": user_prompt,\n",
" }\n",
" ],\n",
" model=model_name,\n",
" temperature=temperature,\n",
" top_p=top_p,\n",
" max_tokens=max_tokens\n",
" )\n",
"\n",
" # 返回第一个选择的内容\n",
" return chat_completion.choices[0].message.content\n",
"\n",
" except Exception as e:\n",
" print(f\"发生错误: {e}\")\n",
" print(\"3秒后重试...\")\n",
" time.sleep(3)"
]
},
{
"cell_type": "markdown",
"id": "63e5feb3-d1ef-4b08-8a65-9a836cb7ca94",
"metadata": {},
"source": [
"直接运行代码,交互式修改参数和 API,不用关心这里的代码细节。\n",
"\n",
"注意:配置完记得点击**提交配置**"
]
},
{
"cell_type": "code",
"execution_count": 16,
"id": "545d70a0-c55e-4c5f-b7df-d349f4e49c57",
"metadata": {},
"outputs": [
{
"data": {
"text/markdown": [
"**openai_api_key**
请输入你的 OpenAI API 密钥:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "e9af7fe4f90d47b4b14069f15556f069",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Password(description='openai_api_key:', placeholder='请输入你的OpenAI API密钥(可以不填写,默认使用环境变量)', style=TextStyle(descr…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**model_name**
请选择模型名称,默认是 'qwen-plus':"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "e6ff847d3f1244b88095342552dd9ff9",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Text(value='qwen-plus', description='model_name:', style=TextStyle(description_width='initial'))"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**temperature**
通过温度值来控制响应的随机性,较低的值使响应更具确定性:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "ff886b9c72d748e498af95264f82f648",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"FloatSlider(value=0.0, continuous_update=False, description='temperature (随机性):', max=1.0, style=SliderStyle(d…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**控制多样性 (Top-P)**
通过 Top-P 核采样控制多样性,较高的值会导致更多样化的响应:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "cba367c9f6ff4f5f99c90b7c91275bf0",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"FloatSlider(value=0.0, continuous_update=False, description='Top-P (多样性):', max=1.0, style=SliderStyle(descrip…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "83ced9ed56eb4ecbb24b96f4e3139477",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Button(description='提交配置', style=ButtonStyle())"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "dc9115d8300c4df0970bc3bea11d0956",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Output()"
]
},
"metadata": {},
"output_type": "display_data"
}
],
"source": [
"# ===== 在此代码块中,你可以修改所需的参数并设置OpenAI API密钥 =====\n",
"\n",
"# 你的OpenAI API密钥部分\n",
"api_key_markdown = Markdown(\"**openai_api_key**
请输入你的 OpenAI API 密钥:\")\n",
"openai_api_key_widget = widgets.Password(\n",
" value=os.getenv('OPENAI_API_KEY'), # 默认使用环境变量\n",
" description='openai_api_key:',\n",
" placeholder='请输入你的OpenAI API密钥(可以不填写,默认使用环境变量)',\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 模型名称部分\n",
"model_name_markdown = Markdown(\"**model_name**
请选择模型名称,默认是 'qwen-plus':\")\n",
"model_name_widget = widgets.Text(\n",
" value='qwen-plus',\n",
" description='model_name:',\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 控制响应的随机性部分\n",
"temperature_markdown = Markdown(\"**temperature**
通过温度值来控制响应的随机性,较低的值使响应更具确定性:\")\n",
"temperature_widget = widgets.FloatSlider(\n",
" value=0,\n",
" min=0,\n",
" max=1,\n",
" step=0.1,\n",
" description='temperature (随机性):',\n",
" continuous_update=False,\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 控制多样性 (Top-P) 部分\n",
"top_p_markdown = Markdown(\"**控制多样性 (Top-P)**
通过 Top-P 核采样控制多样性,较高的值会导致更多样化的响应:\")\n",
"top_p_widget = widgets.FloatSlider(\n",
" value=0,\n",
" min=0,\n",
" max=1,\n",
" step=0.1,\n",
" description='Top-P (多样性):',\n",
" continuous_update=False,\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 创建输出区域来显示打印内容\n",
"output_area = widgets.Output()\n",
"\n",
"# 获取用户输入值并显示\n",
"def on_button_click(b):\n",
" with output_area:\n",
" global openai_api_key, model_name, temperature, top_p\n",
" output_area.clear_output() # 清除之前的输出\n",
" openai_api_key = openai_api_key_widget.value\n",
" model_name = model_name_widget.value\n",
" temperature = temperature_widget.value\n",
" top_p = top_p_widget.value\n",
" \n",
" # 打印配置\n",
" print(f\"OpenAI API密钥: {'*' * len(openai_api_key)}\") # 为了安全性,只显示密钥长度\n",
" print(f\"模型名称: {model_name}\")\n",
" print(f\"温度 (随机性): {temperature}\")\n",
" print(f\"Top-P (多样性): {top_p}\")\n",
"\n",
"# 创建提交按钮\n",
"submit_button = widgets.Button(description=\"提交配置\")\n",
"submit_button.on_click(on_button_click)\n",
"\n",
"# 显示带有说明的所有小部件\n",
"display(api_key_markdown, openai_api_key_widget)\n",
"display(model_name_markdown, model_name_widget)\n",
"display(temperature_markdown, temperature_widget)\n",
"display(top_p_markdown, top_p_widget)\n",
"\n",
"# 显示提交按钮\n",
"display(submit_button)\n",
"\n",
"# 显示输出区域\n",
"display(output_area)"
]
},
{
"cell_type": "code",
"execution_count": 17,
"id": "12a54687-e82c-4f1e-9084-24ac4a8ee317",
"metadata": {},
"outputs": [],
"source": [
"# 构建 OpenAI 客户端\n",
"client = OpenAI(\n",
" api_key=openai_api_key,\n",
" base_url=\"https://dashscope.aliyuncs.com/compatible-mode/v1\", # 这里使用的是阿里云的大模型,如果需要使用其他平台,请参考对应的开发文档后对应修改。如果使用 GPT 的 API,删除这行就可以直接运行。\n",
")"
]
},
{
"attachments": {},
"cell_type": "markdown",
"id": "c2be0de4-f959-460e-9cdf-befc446d90f7",
"metadata": {},
"source": [
"#### 这里演示两种摘要方式\n",
"参考:[Text Summarization of Large Documents using LangChain 🦜🔗](https://github.com/GoogleCloudPlatform/generative-ai/blob/main/language/use-cases/document-summarization/summarization_large_documents_langchain.ipynb)\n",
"\n",
"分别对应于 `MapReduce` 和 `Refine`,你可以通过接下来的代码来感受二者的区别。\n",
"\n",
"不要修改 ``,这是一个占位符,如果你不记得占位符的概念,回看[《03. 进阶指南:自定义 Prompt 提升大模型解题能力》](https://github.com/Hoper-J/AI-Guide-and-Demos-zh_CN/blob/master/Guide/03.%20进阶指南:自定义%20Prompt%20提升大模型解题能力.md#设计prompt解决数学问题)。\n",
"\n",
"##### 方法一:多段摘要方法(Multi-Stage Summarization)- MapReduce\n",
"\n",
"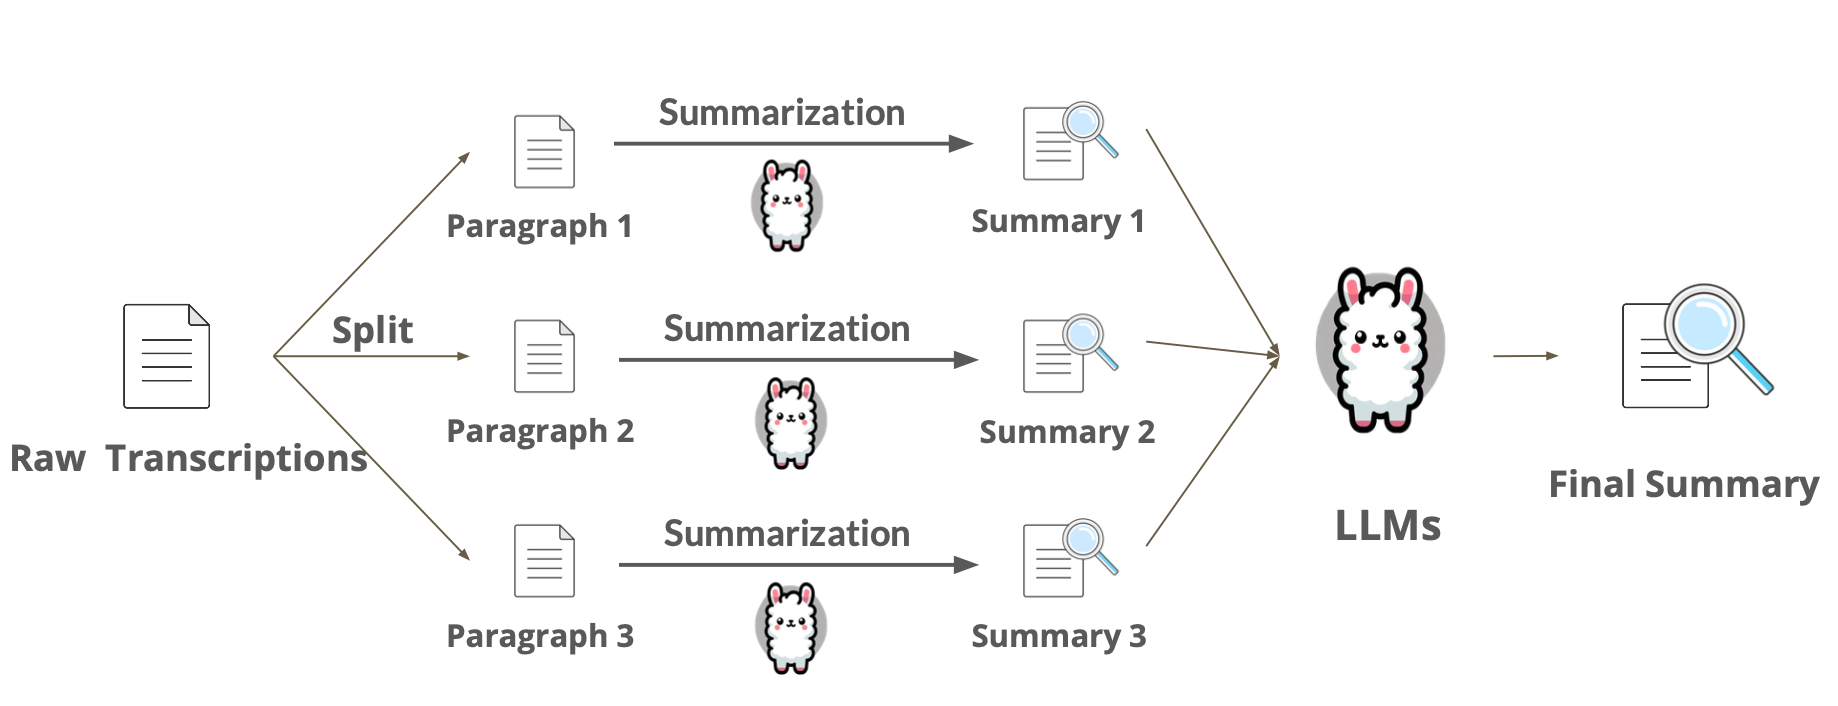\n",
"\n",
"1. 将长文本分成多个较小的部分,并分别获取每个小段落的摘要\n",
"\n",
"注意:配置完记得点击**提交配置**"
]
},
{
"cell_type": "code",
"execution_count": 18,
"id": "461d5e62-0dbe-4f5c-9340-eceb99ec4826",
"metadata": {},
"outputs": [
{
"data": {
"text/markdown": [
"**多段摘要:段落设置**"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**max_tokens**
设置生成的最大tokens:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "ea9d02dbd938453b9e677febbca60e7e",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"IntText(value=350, description='max_tokens:', style=DescriptionStyle(description_width='initial'))"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**summarization_prompt_template**
你可以修改摘要prompt,但不要修改 `` 部分:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "3832cbfe70aa49ffbdd41eab22004d2e",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Textarea(value='用 300 个字内写出这段文字的摘要,其中包括要点和所有重要细节:', description='summarization_prompt_template:', layout…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "5378f5063651467eb6334d83843a097e",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Button(description='提交配置', style=ButtonStyle())"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "4eddda6c5ad64f70af4cc1efe3fbeeee",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Output()"
]
},
"metadata": {},
"output_type": "display_data"
}
],
"source": [
"# ===== 多段摘要:段落设置 =====\n",
"\n",
"# 你可以修改摘要prompt和生成的最大tokens,但不要修改 部分\n",
"instructions = Markdown(\"**多段摘要:段落设置**\")\n",
"\n",
"# 设置最大生成tokens\n",
"max_tokens_markdown = Markdown(\"**max_tokens**
设置生成的最大tokens:\")\n",
"max_tokens_widget = widgets.IntText(\n",
" value=350,\n",
" description='max_tokens:',\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 摘要prompt模板\n",
"summarization_prompt_markdown = Markdown(\"**summarization_prompt_template**
你可以修改摘要prompt,但不要修改 `` 部分:\")\n",
"summarization_prompt_template_widget = widgets.Textarea(\n",
" value=\"用 300 个字内写出这段文字的摘要,其中包括要点和所有重要细节:\",\n",
" description='summarization_prompt_template:',\n",
" layout=widgets.Layout(width='500px', height='100px'),\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 创建输出区域来显示打印内容\n",
"output_area = widgets.Output()\n",
"\n",
"# 获取用户输入值并显示\n",
"def on_button_click(b):\n",
" global max_tokens, summarization_prompt_template\n",
" with output_area:\n",
" output_area.clear_output() # 清除之前的输出\n",
" max_tokens = max_tokens_widget.value\n",
" summarization_prompt_template = summarization_prompt_template_widget.value\n",
" \n",
" # 打印配置\n",
" print(f\"最大tokens: {max_tokens}\")\n",
" print(f\"摘要prompt模板: {summarization_prompt_template}\")\n",
"\n",
"# 创建提交按钮\n",
"submit_button = widgets.Button(description=\"提交配置\")\n",
"submit_button.on_click(on_button_click)\n",
"\n",
"# 显示带有说明的所有小部件\n",
"display(instructions)\n",
"display(max_tokens_markdown, max_tokens_widget)\n",
"display(summarization_prompt_markdown, summarization_prompt_template_widget)\n",
"\n",
"# 显示提交按钮\n",
"display(submit_button)\n",
"\n",
"# 显示输出区域\n",
"display(output_area)"
]
},
{
"cell_type": "code",
"execution_count": 19,
"id": "884abd01-4297-42ee-86e0-c042c0632170",
"metadata": {
"scrolled": true
},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"----------------------------第 1 段的摘要----------------------------\n",
"\n",
"这段文字强调“学问是做出来的”,指出仅听、读无法真正掌握知识。只有通过实践,如完成课程项目或编写程序,才能将所学整合并内化为自己的知识。作者以期末项目和编程习题\n",
"\n",
"为例,说明在动手过程中,学问才会真正被理解与掌握。最后指出,实际操作的成果往往比成绩单更体现真实的学习效果。\n",
"\n",
"第 1 段摘要的长度: 134\n",
"生成第 1 段摘要的时间: 1.31 秒。\n",
"\n",
"----------------------------第 2 段的摘要----------------------------\n",
"\n",
"摘要:许多学生因课程项目繁重而放弃修读,却不知这是最佳学习机会,虽未必带来具体成绩,但有助于全面学习。作者强调,学习应注重思考能力的培养,而非仅追求结果。在读书\n",
"\n",
"时,应深入理解每个数学公式和内容的含义,通过不断思考提升思维习惯。真正的学习在于理解与思考,而非机械记忆。\n",
"\n",
"第 2 段摘要的长度: 133\n",
"生成第 2 段摘要的时间: 0.88 秒。\n",
"\n",
"----------------------------第 3 段的摘要----------------------------\n",
"\n",
"本文强调学习不仅限于课业,还包括课外活动。学习被定义为增长、进步和获得快乐。例如,打球能提升健康、协调能力和团队精神;爬山和旅行也能带来成长与乐趣,都是值得投入\n",
"\n",
"的学习机会。任何能带来积极变化和快乐的活动,都应被视为学习的一部分。\n",
"\n",
"第 3 段摘要的长度: 114\n",
"生成第 3 段摘要的时间: 0.72 秒。\n",
"\n",
"----------------------------第 4 段的摘要----------------------------\n",
"\n",
"这段文字强调谈恋爱、交朋友及参与社团活动都是学习人际互动与沟通的重要途径,能提升对人与人之间情感、期待和感觉的理解。作者认为这些经历对每个人都有帮助,尤其对电机\n",
"\n",
"系同学而言,身边有许多优秀朋友可交往。此外,参与戏剧、舞蹈等社团活动也能带来成长与进步,即使不站在台前,幕后工作同样有价值。总之,这些经历都是宝贵的学习机会。\n",
"\n",
"第 4 段摘要的长度: 159\n",
"生成第 4 段摘要的时间: 1.02 秒。\n",
"\n",
"----------------------------第 5 段的摘要----------------------------\n",
"\n",
"这段文字强调了除专业课程外,参与各类活动(如服装道具组、戏剧社等)对个人成长的重要性。这些经历虽无成绩记录,但能提升团队合作、领导力等“软实力”,对未来发展至关\n",
"\n",
"重要。电机工程等专业需团队协作,而软实力帮助个体在团队中逐步成长,从边缘到核心,推动项目成功。因此,不应忽视这些非学术活动的价值。\n",
"\n",
"第 5 段摘要的长度: 145\n",
"生成第 5 段摘要的时间: 0.77 秒。\n",
"\n",
"----------------------------第 6 段的摘要----------------------------\n",
"\n",
"这段文字强调了“软实力”(soft skills)的重要性,包括沟通、协调、交朋友、说服、团队合作和领导力等能力。这些能力对成功至关重要,许多成功的电机工程师都\n",
"\n",
"具备。虽然少数人天生具备这些能力,但大多数人需要通过课外学习和自我培养来提升。作者分享自己在台大电机系四年中通过努力提升软实力的经历,说明这些能力可通过后天培养\n",
"\n",
"获得,并强调其在个人成长中的关键作用。\n",
"\n",
"第 6 段摘要的长度: 179\n",
"生成第 6 段摘要的时间: 0.95 秒。\n",
"\n",
"----------------------------第 7 段的摘要----------------------------\n",
"\n",
"电机工程师的职业发展黄金期为35至55岁,共20年。此阶段前可能经验不足,之后则因年龄增长而有所下降。不同人的发展轨迹各异:有人起步慢但后期上升快,有人初期快但\n",
"\n",
"后期回落。影响发展的关键因素有四:实力、努力、大智和自我管理(self-deal)。最终成功不取决于单科成绩,而在于这四个方面的影响。\n",
"\n",
"第 7 段摘要的长度: 147\n",
"生成第 7 段摘要的时间: 1.02 秒。\n",
"\n",
"----------------------------第 8 段的摘要----------------------------\n",
"\n",
"摘要:实力指在专业领域内全面学习,避免过度专注而提升综合能力;努力是长期成功的关键;self-\n",
"\n",
"skills包括课外实践等不被重视但重要的技能,有助于个人成长。每个人应设定长程目标,无论是否已有明确方向,都应在适当时候思考自身未来目标。\n",
"\n",
"第 8 段摘要的长度: 117\n",
"生成第 8 段摘要的时间: 0.75 秒。\n",
"\n",
"----------------------------第 9 段的摘要----------------------------\n",
"\n",
"这段文字表达了作者对长期目标的重视。他希望用五年、十年甚至更长时间,投入大量努力将某些事情做到极致,这些事对他有深刻意义,是他真正的长程目标。拥有明确长程目标的\n",
"\n",
"人更容易取得成功。作者提到真正影响人生的四件事,并呼吁观众点赞、订阅、转发和打赏支持其栏目“明镜与点点”。\n",
"\n",
"第 9 段摘要的长度: 133\n",
"生成第 9 段摘要的时间: 0.72 秒。\n",
"\n"
]
}
],
"source": [
"paragraph_summarizations = []\n",
"\n",
"# 首先,我们分别对每个拆分的部分进行摘要。\n",
"for index, chunk in enumerate(chunks):\n",
"\n",
" # 记录开始时间\n",
" start = time.time()\n",
"\n",
" # 构建摘要prompt\n",
" summarization_prompt = summarization_prompt_template.replace(\"\", chunk)\n",
"\n",
" # 分别对每个拆分的部分进行摘要\n",
" response = summarization(client=client, summarization_prompt=summarization_prompt, model_name=model_name, temperature=temperature, top_p=top_p, max_tokens=max_tokens)\n",
"\n",
" # 计算执行时间,并保留两位小数\n",
" cost_time = round(time.time() - start, 2)\n",
"\n",
" # 打印摘要及其长度\n",
" print(f\"----------------------------第 {index + 1} 段的摘要----------------------------\\n\")\n",
" for text in textwrap.wrap(response, 80):\n",
" print(f\"{text}\\n\")\n",
" print(f\"第 {index + 1} 段摘要的长度: {len(response)}\")\n",
" print(f\"生成第 {index + 1} 段摘要的时间: {cost_time} 秒。\\n\")\n",
"\n",
" # 记录结果\n",
" paragraph_summarizations.append(response)"
]
},
{
"cell_type": "code",
"execution_count": 20,
"id": "bf766a69-e672-4b8e-b7fb-08224bbb765a",
"metadata": {
"scrolled": true
},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"第 1 段的摘要: 这段文字强调“学问是做出来的”,指出仅听、读无法真正掌握知识。只有通过实践,如完成课程项目或编写程序,才能将所学整合并内化为自己的知识。作者以期末项目和编程习题为例,说明在动手过程中,学问才会真正被理解与掌握。最后指出,实际操作的成果往往比成绩单更体现真实的学习效果。\n",
"第 2 段的摘要: 摘要:许多学生因课程项目繁重而放弃修读,却不知这是最佳学习机会,虽未必带来具体成绩,但有助于全面学习。作者强调,学习应注重思考能力的培养,而非仅追求结果。在读书时,应深入理解每个数学公式和内容的含义,通过不断思考提升思维习惯。真正的学习在于理解与思考,而非机械记忆。\n",
"第 3 段的摘要: 本文强调学习不仅限于课业,还包括课外活动。学习被定义为增长、进步和获得快乐。例如,打球能提升健康、协调能力和团队精神;爬山和旅行也能带来成长与乐趣,都是值得投入的学习机会。任何能带来积极变化和快乐的活动,都应被视为学习的一部分。\n",
"第 4 段的摘要: 这段文字强调谈恋爱、交朋友及参与社团活动都是学习人际互动与沟通的重要途径,能提升对人与人之间情感、期待和感觉的理解。作者认为这些经历对每个人都有帮助,尤其对电机系同学而言,身边有许多优秀朋友可交往。此外,参与戏剧、舞蹈等社团活动也能带来成长与进步,即使不站在台前,幕后工作同样有价值。总之,这些经历都是宝贵的学习机会。\n",
"第 5 段的摘要: 这段文字强调了除专业课程外,参与各类活动(如服装道具组、戏剧社等)对个人成长的重要性。这些经历虽无成绩记录,但能提升团队合作、领导力等“软实力”,对未来发展至关重要。电机工程等专业需团队协作,而软实力帮助个体在团队中逐步成长,从边缘到核心,推动项目成功。因此,不应忽视这些非学术活动的价值。\n",
"第 6 段的摘要: 这段文字强调了“软实力”(soft skills)的重要性,包括沟通、协调、交朋友、说服、团队合作和领导力等能力。这些能力对成功至关重要,许多成功的电机工程师都具备。虽然少数人天生具备这些能力,但大多数人需要通过课外学习和自我培养来提升。作者分享自己在台大电机系四年中通过努力提升软实力的经历,说明这些能力可通过后天培养获得,并强调其在个人成长中的关键作用。\n",
"第 7 段的摘要: 电机工程师的职业发展黄金期为35至55岁,共20年。此阶段前可能经验不足,之后则因年龄增长而有所下降。不同人的发展轨迹各异:有人起步慢但后期上升快,有人初期快但后期回落。影响发展的关键因素有四:实力、努力、大智和自我管理(self-deal)。最终成功不取决于单科成绩,而在于这四个方面的影响。\n",
"第 8 段的摘要: 摘要:实力指在专业领域内全面学习,避免过度专注而提升综合能力;努力是长期成功的关键;self-skills包括课外实践等不被重视但重要的技能,有助于个人成长。每个人应设定长程目标,无论是否已有明确方向,都应在适当时候思考自身未来目标。\n",
"第 9 段的摘要: 这段文字表达了作者对长期目标的重视。他希望用五年、十年甚至更长时间,投入大量努力将某些事情做到极致,这些事对他有深刻意义,是他真正的长程目标。拥有明确长程目标的人更容易取得成功。作者提到真正影响人生的四件事,并呼吁观众点赞、订阅、转发和打赏支持其栏目“明镜与点点”。\n",
"\n"
]
}
],
"source": [
"# 收集之前获得的所有摘要并打印它们\n",
"\n",
"collected_summarization = \"\"\n",
"for index, paragraph_summarization in enumerate(paragraph_summarizations):\n",
" collected_summarization += f\"第 {index + 1} 段的摘要: {paragraph_summarization}\\n\"\n",
"\n",
"print(collected_summarization)"
]
},
{
"cell_type": "markdown",
"id": "7f858025-b73b-4906-9ac6-c05899622f61",
"metadata": {},
"source": [
"2. 在分别获取每个小段落的摘要后,处理这些摘要以生成最终的摘要。\n",
"\n",
"直接运行代码,交互式修改,不用关心这里的代码细节。\n",
"\n",
"注意:配置完记得点击**提交配置**"
]
},
{
"cell_type": "code",
"execution_count": 21,
"id": "4aa1fb50-dab9-4d3f-9c0e-a5777ca13386",
"metadata": {},
"outputs": [
{
"data": {
"text/markdown": [
"**多段摘要:总摘要**"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**max_tokens**
我们设置生成的最大tokens,确保最终摘要不超过 550 个标记。"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "cca5d3c1d85b4f4a8b605da684a0fd8b",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"IntText(value=550, description='max_tokens:', style=DescriptionStyle(description_width='initial'))"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**summarization_prompt**
你可以修改摘要prompt,但不要修改 `` 部分:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "7b47189065bf4a9289570a399a82276a",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Textarea(value='在500字以内写出以下文字的简洁摘要:', description='summarization_prompt:', layout=Layout(height='100px',…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "1d6a26974d874490a59beb1b6f540ddc",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Button(description='提交配置', style=ButtonStyle())"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "fe6023b4c36e43688101f32f5f1addb7",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Output()"
]
},
"metadata": {},
"output_type": "display_data"
}
],
"source": [
"# ===== 多段摘要:总摘要设置 =====\n",
"\n",
"# 你可以修改摘要prompt和生成的最大tokens,但不要修改 部分\n",
"instructions = Markdown(\"**多段摘要:总摘要**\")\n",
"\n",
"# 设置生成的最大tokens\n",
"max_tokens_markdown = Markdown(\"**max_tokens**
我们设置生成的最大tokens,确保最终摘要不超过 550 个标记。\")\n",
"max_tokens_widget = widgets.IntText(\n",
" value=550,\n",
" description='max_tokens:',\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 摘要prompt模板\n",
"summarization_prompt_markdown = Markdown(\"**summarization_prompt**
你可以修改摘要prompt,但不要修改 `` 部分:\")\n",
"summarization_prompt_widget = widgets.Textarea(\n",
" value=\"在500字以内写出以下文字的简洁摘要:\",\n",
" description='summarization_prompt:',\n",
" layout=widgets.Layout(width='500px', height='100px'),\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 创建输出区域来显示打印内容\n",
"output_area = widgets.Output()\n",
"\n",
"# 获取用户输入值并显示\n",
"def on_button_click(b):\n",
" global max_tokens, summarization_prompt_template\n",
" with output_area:\n",
" output_area.clear_output() # 清除之前的输出\n",
" max_tokens = max_tokens_widget.value\n",
" summarization_prompt_template = summarization_prompt_widget.value\n",
" \n",
" # 打印配置\n",
" print(f\"最大tokens: {max_tokens}\")\n",
" print(f\"摘要prompt模板: {summarization_prompt_template}\")\n",
"\n",
"# 创建提交按钮\n",
"submit_button = widgets.Button(description=\"提交配置\")\n",
"submit_button.on_click(on_button_click)\n",
"\n",
"# 显示带有说明的所有小部件\n",
"display(instructions)\n",
"display(max_tokens_markdown, max_tokens_widget)\n",
"display(summarization_prompt_markdown, summarization_prompt_widget)\n",
"\n",
"# 显示提交按钮\n",
"display(submit_button)\n",
"\n",
"# 显示输出区域\n",
"display(output_area)"
]
},
{
"cell_type": "markdown",
"id": "77af801d-2e6b-401a-8bc2-107c11b56bd0",
"metadata": {},
"source": [
"实际运行时间与 API 有关。"
]
},
{
"cell_type": "code",
"execution_count": 22,
"id": "b5f75dc8-fbcd-4246-8b55-cb8d98703a74",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"----------------------------最终摘要----------------------------\n",
"\n",
"本文强调学习需通过实践掌握知识,如课程项目和编程,才能真正理解。学习应注重思考而非成绩,课外活动和人际交往也是重要学习途径。软实力如沟通、团队合作对职业发展至关\n",
"重要。电机工程师的黄金期为35至55岁,成功取决于实力、努力、智慧与自我管理。设定长期目标有助于个人成长与成功。\n",
"\n",
"最终摘要的长度: 136\n",
"生成最终摘要所需的时间: 0.78 秒。\n"
]
}
],
"source": [
"# 记录开始时间\n",
"start = time.time()\n",
"\n",
"# 运行最终摘要生成\n",
"summarization_prompt = summarization_prompt_template.replace(\"\", collected_summarization)\n",
"final_summarization = summarization(client=client, summarization_prompt=summarization_prompt, model_name=model_name, temperature=temperature, top_p=top_p, max_tokens=max_tokens)\n",
"\n",
"# 计算执行时间并四舍五入到两位小数\n",
"cost_time = round(time.time() - start, 2)\n",
"\n",
"# 打印摘要及其长度\n",
"print(f\"----------------------------最终摘要----------------------------\\n\")\n",
"for text in textwrap.wrap(final_summarization, 80):\n",
" print(f\"{text}\")\n",
"print(f\"\\n最终摘要的长度: {len(final_summarization)}\")\n",
"print(f\"生成最终摘要所需的时间: {cost_time} 秒。\")"
]
},
{
"cell_type": "code",
"execution_count": 23,
"id": "193dfad3-a71c-42dd-9873-4f762894bb29",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"最终摘要已保存到 ./final-summary-信号与人生-llm-multi-stage.txt\n",
"\n",
"===== 以下是最终摘要 (136 字) =====\n",
"\n",
"本文强调学习需通过实践掌握知识,如课程项目和编程,才能真正理解。学习应注重思考而非成绩,课外活动和人际交往也是重要学习途径。软实\n",
"力如沟通、团队合作对职业发展至关重要。电机工程师的黄金期为35至55岁,成功取决于实力、努力、智慧与自我管理。设定长期目标有助于\n",
"个人成长与成功。\n"
]
}
],
"source": [
"# 你可以修改最终摘要的输出路径。\n",
"output_path = f\"./final-summary-{suffix}-llm-multi-stage.txt\"\n",
"\n",
"# 如果需要将简体中文转换为繁体中文,请将此选项设置为 True;否则,设置为 False。\n",
"convert_to_tradition_chinese = False\n",
"\n",
"if convert_to_tradition_chinese == True:\n",
" # 创建一个 OpenCC 实例用于简体到繁体中文转换。\n",
" cc = OpenCC('s2t')\n",
" final_summarization = cc.convert(final_summarization)\n",
"\n",
"# 输出最终摘要\n",
"with open(output_path, \"w\") as fp:\n",
" fp.write(final_summarization)\n",
"\n",
"# 显示结果\n",
"print(f\"最终摘要已保存到 {output_path}\")\n",
"print(f\"\\n===== 以下是最终摘要 ({len(final_summarization)} 字) =====\\n\")\n",
"for text in textwrap.wrap(final_summarization, 64):\n",
" print(text)"
]
},
{
"cell_type": "markdown",
"id": "27b6f8e0-b0cc-4e9f-ae74-81fd75225d22",
"metadata": {},
"source": [
"##### 方法二:精炼方法(the method of Refinement) - Refine\n",
"\n",
"Refinement 就是把每次的文本和之前的摘要结合起来丢给大模型,类似于迭代:\n",
"\n",
"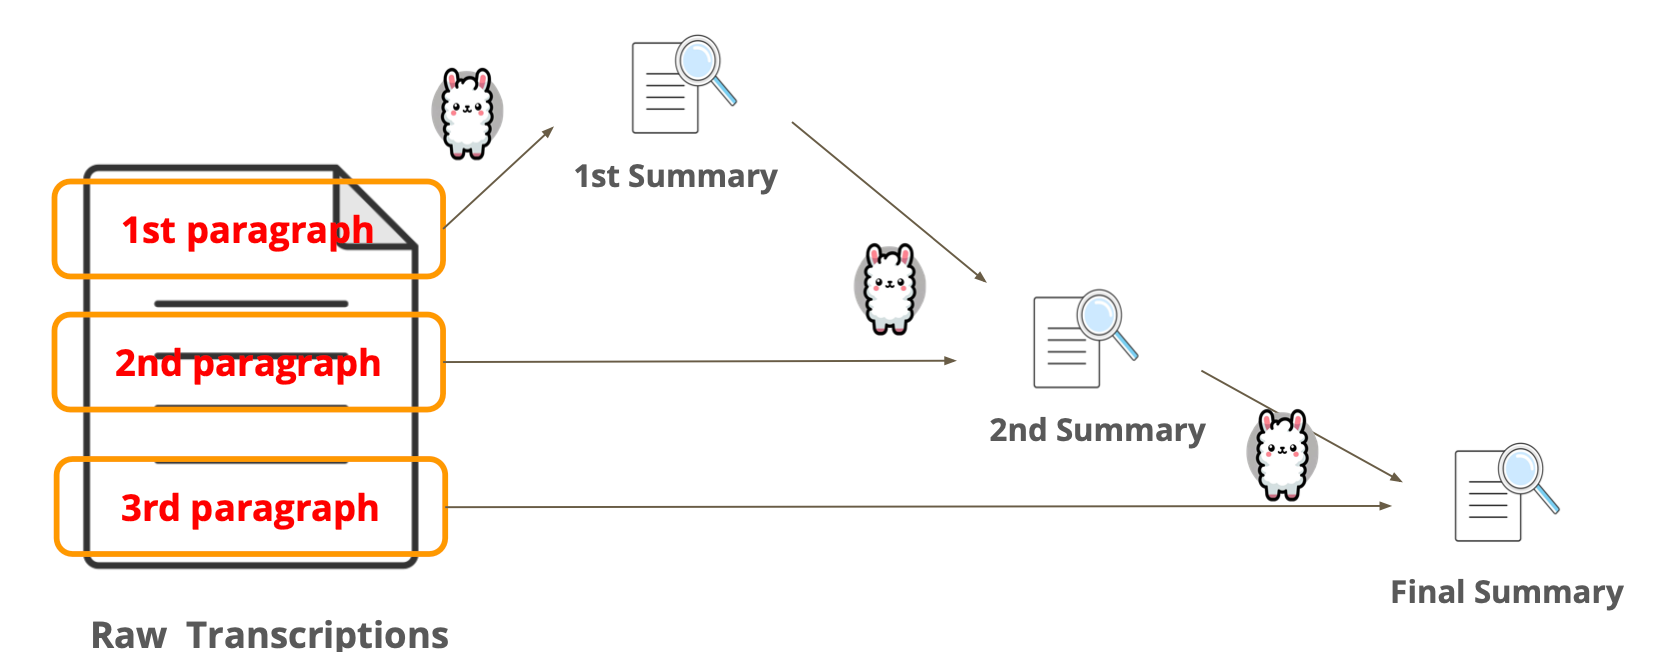\n",
"\n",
"步骤(Pipeline)如下:\n",
"- 第1步:从一小部分数据开始,运行prompt生成初始输出。\n",
"- 第2步:对后续每个文档,将前一个输出与新文档结合输入。\n",
"- 第3步:LLM 根据新文档中的信息精炼输出。\n",
"- 第4步:此过程持续迭代,直到处理完所有文档。\n",
"\n",
"对应的核心代码:\n",
"```python\n",
" # 第1步\n",
" first_paragraph_summarization = summarization(client=client, summarization_prompt=summarization_prompt, ...)\n",
" # 第2步\n",
" chunk_text = f\"\"\"前 {index} 段的摘要: {paragraph_summarizations[-1]}\\n第 {index + 1} 段的内容: {chunk}\"\"\"\n",
" # 第3步\n",
" paragraph_summarization = summarization(client=client, summarization_prompt=summarization_prompt, ...)\n",
"```\n",
"\n",
"直接运行代码,交互式修改,不用关心这里的代码细节。\n",
"\n",
"注意:配置完记得点击**提交配置**"
]
},
{
"cell_type": "code",
"execution_count": 24,
"id": "6fb36291-a394-4e12-bb5d-3e9250cb464a",
"metadata": {},
"outputs": [
{
"data": {
"text/markdown": [
"**精炼摘要的prompt设置**"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**max_tokens**
设置最大生成tokens"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "6b5ba03859134abc8ce9a82714988608",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"IntText(value=550, description='max_tokens:', style=DescriptionStyle(description_width='initial'))"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**summarization_prompt**
你可以修改初始摘要prompt,但不要修改 `` 部分:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "5968be33a7ee4d6896afe60556cd8667",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Textarea(value='请在 300 字以内,提供以下文字的简洁摘要:', description='summarization_prompt:', layout=Layout(height='100…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"text/markdown": [
"**summarization_prompt_refinement**
你可以修改精炼摘要prompt,但不要修改 `` 部分:"
],
"text/plain": [
""
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "f445f71ad3224b58850eaf7651623995",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Textarea(value='请在 500 字以内,结合原先的摘要和新的内容,提供简洁的摘要:', description='summarization_prompt_refinement:', layou…"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "eb3ef3e0cab945b7a640de5ffa9d3606",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Button(description='提交配置', style=ButtonStyle())"
]
},
"metadata": {},
"output_type": "display_data"
},
{
"data": {
"application/vnd.jupyter.widget-view+json": {
"model_id": "859c9ff74dec44e5a52abc2149a2f494",
"version_major": 2,
"version_minor": 0
},
"text/plain": [
"Output()"
]
},
"metadata": {},
"output_type": "display_data"
}
],
"source": [
"# ===== 精炼摘要的prompt设置 =====\n",
"\n",
"# 你可以修改摘要prompt和最大生成tokens,但不要修改 部分\n",
"instructions = Markdown(\"**精炼摘要的prompt设置**\")\n",
"\n",
"# 设置最大生成tokens\n",
"max_tokens_markdown = Markdown(\"**max_tokens**
设置最大生成tokens\")\n",
"max_tokens_widget = widgets.IntText(\n",
" value=550,\n",
" description='max_tokens:',\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 初始摘要prompt\n",
"summarization_prompt_markdown = Markdown(\"**summarization_prompt**
你可以修改初始摘要prompt,但不要修改 `` 部分:\")\n",
"summarization_prompt_widget = widgets.Textarea(\n",
" value=\"请在 300 字以内,提供以下文字的简洁摘要:\",\n",
" description='summarization_prompt:',\n",
" layout=widgets.Layout(width='500px', height='100px'),\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 精炼摘要prompt\n",
"summarization_prompt_refinement_markdown = Markdown(\"**summarization_prompt_refinement**
你可以修改精炼摘要prompt,但不要修改 `` 部分:\")\n",
"summarization_prompt_refinement_widget = widgets.Textarea(\n",
" value=\"请在 500 字以内,结合原先的摘要和新的内容,提供简洁的摘要:\",\n",
" description='summarization_prompt_refinement:',\n",
" layout=widgets.Layout(width='500px', height='100px'),\n",
" style={'description_width': 'initial'}\n",
")\n",
"\n",
"# 创建输出区域来显示打印内容\n",
"output_area = widgets.Output()\n",
"\n",
"# 获取用户输入值并显示\n",
"def on_button_click(b):\n",
" global max_tokens, summarization_prompt_template, summarization_prompt_refinement_template\n",
" with output_area:\n",
" output_area.clear_output() # 清除之前的输出\n",
" max_tokens = max_tokens_widget.value\n",
" summarization_prompt_template = summarization_prompt_widget.value\n",
" summarization_prompt_refinement_template = summarization_prompt_refinement_widget.value\n",
" \n",
" # 打印配置\n",
" print(f\"最大tokens: {max_tokens}\")\n",
" print(f\"初始摘要prompt: {summarization_prompt_template}\")\n",
" print(f\"精炼摘要prompt: {summarization_prompt_refinement_template}\")\n",
"\n",
"# 创建提交按钮\n",
"submit_button = widgets.Button(description=\"提交配置\")\n",
"submit_button.on_click(on_button_click)\n",
"\n",
"# 显示 Markdown 和所有小部件\n",
"display(instructions)\n",
"display(max_tokens_markdown, max_tokens_widget)\n",
"display(summarization_prompt_markdown, summarization_prompt_widget)\n",
"display(summarization_prompt_refinement_markdown, summarization_prompt_refinement_widget)\n",
"\n",
"# 显示提交按钮\n",
"display(submit_button)\n",
"\n",
"# 显示输出区域\n",
"display(output_area)"
]
},
{
"cell_type": "code",
"execution_count": 25,
"id": "d8afe5b7-2604-40bf-97c9-a8dd91f0e40e",
"metadata": {
"scrolled": true
},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"----------------------------第 1 段摘要----------------------------\n",
"\n",
"这段文字表达了作者对长期目标的重视。他希望用五年、十年甚至更长时间,投入大量努力将某些事情做到极致,这些事对他有深刻意义,是他真正的长程目标。拥有明确长程目标的人更容易取得成功。作者提到真正影响人生的四件事,并呼吁观众点赞、订阅、转发和打赏支持其栏目“明镜与点点”。\n",
"\n",
"第 1 段摘要的长度: 102\n",
"生成第 1 段摘要所需的时间: 0.78 秒。\n",
"\n",
"----------------------------前 2 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识掌握的重要性。仅听讲或阅读不足以内化知识,必须通过动手实践,如完成项目或编写程序,才能真正理解。许多学生因课程任务繁重而放弃,却不知这些实践正是学习的关键机会。即使看似无直接成果,它们有助于全面学习和思维能力的培养。在学习过程中,应主动思考,理解每个数学公式或概念的实际含义,培养独立思考的习惯,这才是学习的核心。\n",
"\n",
"前 2 段摘要的长度: 173\n",
"生成前 2 段摘要所需的时间: 1.01 秒。\n",
"\n",
"----------------------------前 3 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识掌握的重要性,仅听讲或阅读不足以内化知识,必须通过动手实践才能真正理解。课业内外的学习都应注重实践与思考,课业外的活动如打球、爬山、旅行等,只要带来成长与快乐,同样是学习的重要部分。学习不仅是获取知识,更是不断进步与享受的过程,应主动探索,培养独立思考与全面发展的能力。\n",
"\n",
"前 3 段摘要的长度: 151\n",
"生成前 3 段摘要所需的时间: 0.89 秒。\n",
"\n",
"----------------------------前 4 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识掌握的重要性,仅听讲或阅读不足以内化知识,必须通过动手实践才能真正理解。课业内外的学习都应注重实践与思考,课业外的活动如打球、爬山、旅行、交朋友、参加社团等,只要带来成长与快乐,同样是学习的重要部分。谈恋爱、交朋友、参与戏剧、舞蹈等活动,都能让人体验人际互动、沟通与情感,促进全面发展。这些经历不仅丰富人生,也提升个人能力,是学习不可或缺的一部分。\n",
"\n",
"前 4 段摘要的长度: 190\n",
"生成前 4 段摘要所需的时间: 0.93 秒。\n",
"\n",
"----------------------------前 5 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识掌握的重要性,仅靠听讲或阅读难以内化知识,必须通过动手实践才能真正理解。课业内外的学习都应注重实践与思考,如打球、旅行、交朋友、参与社团等,都能带来成长与快乐,是学习的重要部分。第5段指出,服装道具组、戏剧、舞蹈等课外活动同样能促进个人成长,提升软实力,如团队合作、沟通与领导能力。这些经历虽无考试成绩,但对个人发展至关重要。电机工程等学科更需团队协作,学会融入团队、逐步成长,培养软实力,是成功的关键。\n",
"\n",
"前 5 段摘要的长度: 218\n",
"生成前 5 段摘要所需的时间: 1.49 秒。\n",
"\n",
"----------------------------前 6 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识掌握的重要性,仅靠听讲或阅读难以内化知识,必须通过动手实践才能真正理解。课业内外的学习都应注重实践与思考,如打球、旅行、交朋友、参与社团等,都能带来成长与快乐,是学习的重要部分。课外活动如服装道具组、戏剧、舞蹈等同样能提升软实力,如团队合作、沟通与领导能力。这些能力虽无考试成绩,但对个人发展至关重要。软实力包括沟通、协调、说服、团队精神等,是成功的关键。许多成功的电机工程师正是依靠这些能力取得成就,而这些能力多通过课外经历逐步培养。作者自身在台大电机系四年中,通过实践提升了软实力,因此强调其重要性。\n",
"\n",
"前 6 段摘要的长度: 268\n",
"生成前 6 段摘要所需的时间: 1.37 秒。\n",
"\n",
"----------------------------前 7 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识掌握的重要性,仅靠听讲或阅读难以内化知识,必须通过动手实践才能真正理解。课外活动如戏剧、舞蹈、社团等能提升沟通、团队合作等软实力,对个人发展至关重要。电机工程师的职业生涯黄金期在35至55岁,此阶段发展最为关键。个人成长轨迹各异,有的起步慢但后期发展快,有的初期迅速但后期趋于平稳。影响职业发展的主要因素包括实力、努力、大智与自我管理,而非单纯学术成绩。\n",
"\n",
"前 7 段摘要的长度: 193\n",
"生成前 7 段摘要所需的时间: 0.91 秒。\n",
"\n",
"----------------------------前 8 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识内化的重要性,仅靠听讲或阅读难以掌握。课外活动能提升软实力,对个人发展至关重要。电机工程师职业黄金期在35至55岁,个人成长轨迹各异,影响因素包括实力、努力、大智与自我管理。实力源于全面学习,避免片面;努力决定长期表现;自我技能(如课外实践)同样关键。每个人应有长程目标,明确发展方向,以实现持续成长。\n",
"\n",
"前 8 段摘要的长度: 167\n",
"生成前 8 段摘要所需的时间: 1.07 秒。\n",
"\n",
"----------------------------前 9 段摘要----------------------------\n",
"\n",
"“学问是做出来的”强调实践对知识内化的重要性,课外活动能提升软实力,促进个人发展。电机工程师职业黄金期在35至55岁,个人成长受实力、努力、智慧与自我管理影响。实力源于全面学习,努力决定长期表现,技能提升需结合实践。每个人应设定长程目标,明确方向,持续成长。长程目标若能带来意义感,便能激发持久动力,越有此目标者越易成功。\n",
"\n",
"前 9 段摘要的长度: 161\n",
"生成前 9 段摘要所需的时间: 0.88 秒。\n",
"\n"
]
}
],
"source": [
"paragraph_summarizations = []\n",
"\n",
"# 首先,我们分别对拆分后的每个部分进行摘要。\n",
"for index, chunk in enumerate(chunks):\n",
"\n",
" if index == 0:\n",
" # 记录开始时间\n",
" start = time.time()\n",
"\n",
" # 构建初始摘要prompt\n",
" summarization_prompt = summarization_prompt_template.replace(\"\", chunk)\n",
"\n",
" # 第1步: 从一小部分数据开始,运行prompt生成初始输出\n",
" first_paragraph_summarization = summarization(client=client, summarization_prompt=summarization_prompt, model_name=model_name, temperature=temperature, top_p=top_p, max_tokens=max_tokens)\n",
"\n",
" # 记录结果\n",
" paragraph_summarizations.append(first_paragraph_summarization)\n",
"\n",
" # 计算执行时间并四舍五入到两位小数\n",
" cost_time = round(time.time() - start, 2)\n",
"\n",
" # 打印摘要及其长度\n",
" print(f\"----------------------------第 {index + 1} 段摘要----------------------------\\n\")\n",
" print(f\"{first_paragraph_summarization}\\n\")\n",
" print(f\"第 {index + 1} 段摘要的长度: {len(first_paragraph_summarization)}\")\n",
" print(f\"生成第 {index + 1} 段摘要所需的时间: {cost_time} 秒。\\n\")\n",
"\n",
" else:\n",
" # 记录开始时间\n",
" start = time.time()\n",
"\n",
" # 第2步:将前一个输出与新文档结合输入\n",
" chunk_text = f\"\"\"前 {index} 段的摘要: {paragraph_summarizations[-1]}\\n第 {index + 1} 段的内容: {chunk}\"\"\"\n",
"\n",
" # 构建精炼摘要prompt\n",
" summarization_prompt = summarization_prompt_refinement_template.replace(\"\", chunk_text)\n",
"\n",
" # 第3步:LLM 被指示根据新文档中的信息精炼输出\n",
" paragraph_summarization = summarization(client=client, summarization_prompt=summarization_prompt, model_name=model_name, temperature=temperature, top_p=top_p, max_tokens=max_tokens)\n",
"\n",
" # 记录结果\n",
" paragraph_summarizations.append(paragraph_summarization)\n",
"\n",
" # 计算执行时间并四舍五入到两位小数\n",
" cost_time = round(time.time() - start, 2)\n",
"\n",
" # 打印结果\n",
" print(f\"----------------------------前 {index + 1} 段摘要----------------------------\\n\")\n",
" print(f\"{paragraph_summarization}\\n\")\n",
" print(f\"前 {index + 1} 段摘要的长度: {len(paragraph_summarization)}\")\n",
" print(f\"生成前 {index + 1} 段摘要所需的时间: {cost_time} 秒。\\n\")\n",
"\n",
" # 第4步:此过程持续迭代,直到处理完所有文档。"
]
},
{
"cell_type": "code",
"execution_count": 26,
"id": "5fe9f4e4-e0ff-4891-9443-cdaab9898451",
"metadata": {},
"outputs": [
{
"name": "stdout",
"output_type": "stream",
"text": [
"最终摘要已保存到 ./final-summary-信号与人生-llm-refinement.txt\n",
"\n",
"===== 以下是最终摘要 (161 字) =====\n",
"\n",
"“学问是做出来的”强调实践对知识内化的重要性,课外活动能提升软实力,促进个人发展。电机工程师职业黄金期在35至55岁,个人成长受实力、努力、智慧与自我管理影响。实力源于全面学习,努力决定长期表现,技能提升需结合实践。每个人应设定长程目标,明确方向,持续成长。长程目标若能带来意义感,便能激发持久动力,越有此目标者越易成功。\n"
]
}
],
"source": [
"# 你可以修改最终摘要的输出路径。\n",
"\n",
"output_path = f\"./final-summary-{suffix}-llm-refinement.txt\"\n",
"\n",
"# 如果需要将简体中文转换为繁体中文,请将此选项设置为 True;否则,设置为 False。\n",
"convert_to_tradition_chinese = False\n",
"\n",
"if convert_to_tradition_chinese == True:\n",
" # 创建一个 OpenCC 实例用于简体到繁体中文转换。\n",
" cc = OpenCC('s2t')\n",
" paragraph_summarizations[-1] = cc.convert(paragraph_summarizations[-1])\n",
"\n",
"# 输出最终摘要\n",
"with open(output_path, \"w\") as fp:\n",
" fp.write(paragraph_summarizations[-1])\n",
"\n",
"# 显示结果\n",
"print(f\"最终摘要已保存到 {output_path}\")\n",
"print(f\"\\n===== 以下是最终摘要 ({len(paragraph_summarizations[-1])} 字) =====\\n\")\n",
"print(paragraph_summarizations[-1])"
]
},
{
"cell_type": "markdown",
"id": "75ec97da-65e1-4c42-ae77-1806d8297cde",
"metadata": {},
"source": [
"## 总结\n",
"\n",
"通过这个代码文件,你将了解如何:\n",
"\n",
"1. 使用 Whisper 模型从视频音频生成字幕。\n",
"2. 将字幕文件中的内容提取并处理,转换为文本格式。\n",
"3. 使用 OpenAI API 为文本生成摘要。\n",
"\n",
"你也将:\n",
"1. 理解 AI 视频总结助手实际上是如何工作的。\n",
"2. 发现 AI 应用实际真的并不难,你完全有能力制作一个属于自己的 AI 应用。\n"
]
},
{
"cell_type": "code",
"execution_count": null,
"id": "a87465b2-c48c-4769-b463-cad424d8b9d2",
"metadata": {},
"outputs": [],
"source": []
}
],
"metadata": {
"kernelspec": {
"display_name": "ai",
"language": "python",
"name": "ai"
},
"language_info": {
"codemirror_mode": {
"name": "ipython",
"version": 3
},
"file_extension": ".py",
"mimetype": "text/x-python",
"name": "python",
"nbconvert_exporter": "python",
"pygments_lexer": "ipython3",
"version": "3.12.12"
}
},
"nbformat": 4,
"nbformat_minor": 5
}